机器人学习的数据层税
译文说明
原文:The data layer tax for robot learning,作者 Nikolaus West(Rerun 联合创始人 & CEO),发表于 Rerun 博客(2026-04-30)。译文仅供参考学习,一切图像与视频素材版权归 Rerun Technologies AB 所有。
Scaling law 开始在机器人领域生效,带来了几年前难以想象的能力。端到端模型直接从传感器输入预测机器人动作,这简化了机器人上的软件,却让从数据采集到训练的一切都变得更加困难。LLM 团队依靠成熟的数据基础设施实现规模化,通过对数据的快速迭代来提升性能。机器人团队却在没有它的情况下试图规模化。
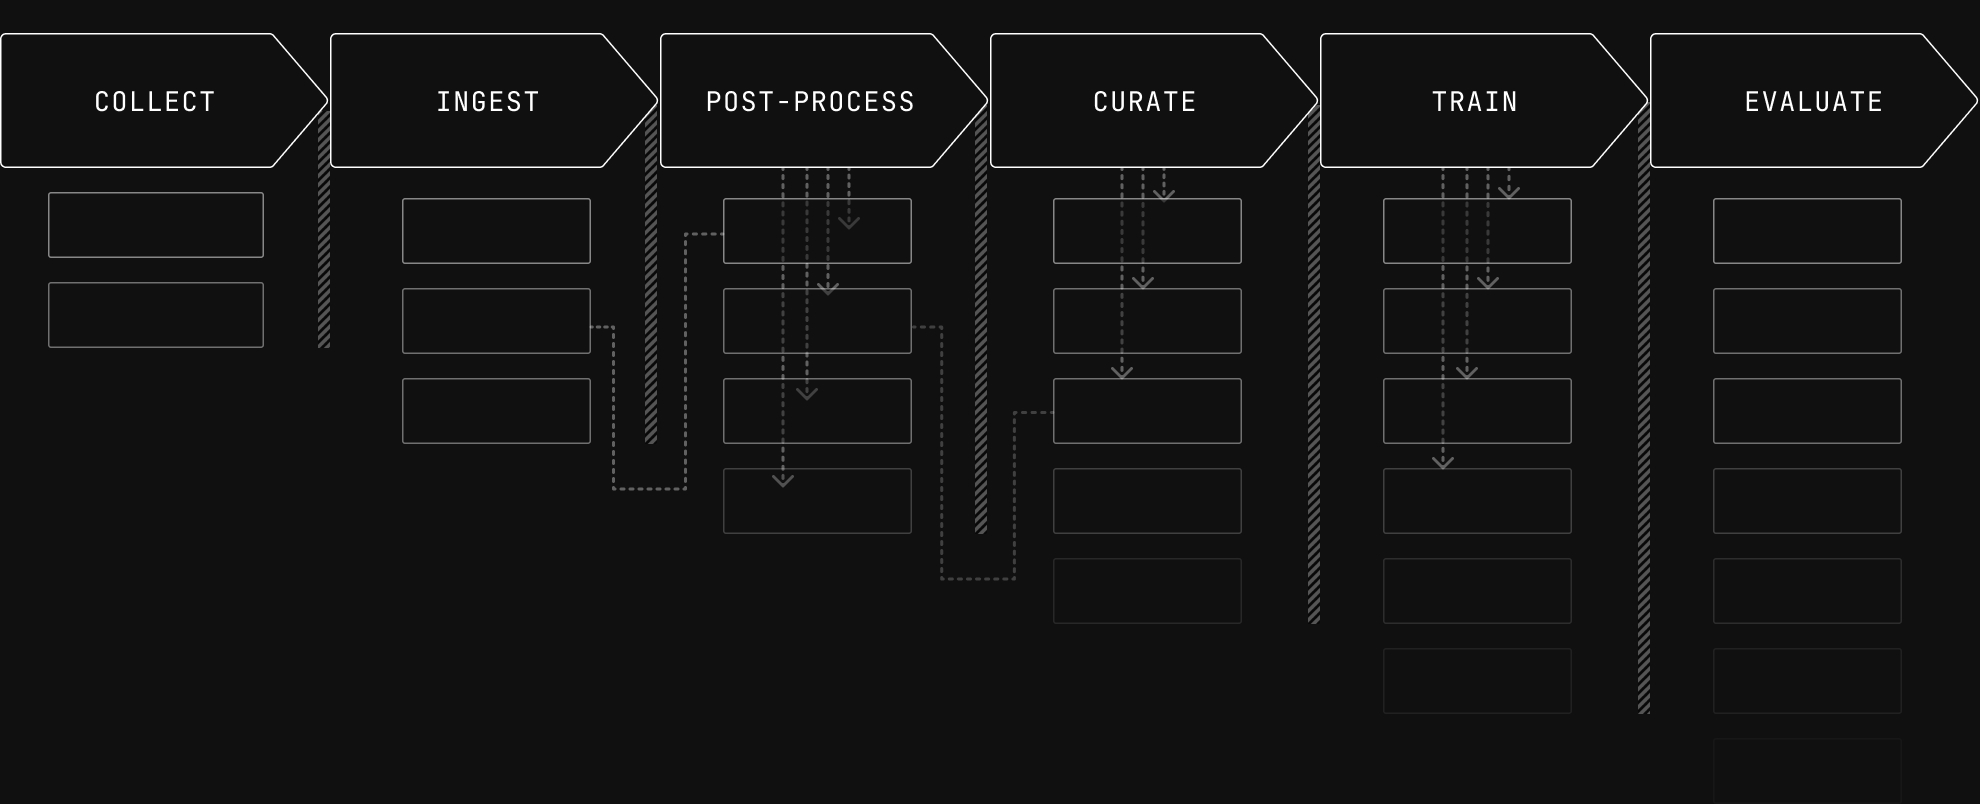
大多数团队从零构建数据工具,因为现有的基础设施并不是为驱动机器人学习的多速率、多模态数据而设计的。在从采集到训练的数据旅程中,常见操作都比它们本该有的样子更难、更慢。这种累积成本——体现在迭代速度、工程注意力和 GPU 利用率上——就是我们所说的数据层税。在这场通往史上最大市场的竞赛中,降低这笔税是跑得更快的重大杠杆。
从架构上说,数据层负责数据的存储、建模和访问。物理 AI 的数据层仍然不成熟,其代价在流水线的每个阶段都清晰可见。
如果你正在构建或投资机器人学习,本文就是一张"这笔税从何而来"的地图。我们将从评估一路倒走回采集,展示需求如何向上游层层传导,以及为什么这笔税会随着数据规模、来源多样性和筛选精细度而复利增长。
策略评估
大量 "eval" 是任何 LLM 团队快速进步的核心。机器人行为的评估要困难得多,这对整条流水线产生级联效应。对机器人团队来说,即使对一个训练好的策略做一次小规模的真实世界评估,也需要数小时乃至数天的机器人试验,以及精心的设计与操作。这意味着在机器人领域,靠大规模、可复现、快速的 eval 来快速推进是不可行的。
团队转而依赖直接给数据质量打分的代理指标,比如评估任务进度的 reward model、作为标定正确性信号的 3D 重建质量,或者干脆估算轨迹的抖动程度。这些指标告诉你单个 episode 或样本看起来是好是坏,而不是它们能否产生更好的策略。
由于真实评估运行更难做,深入研究每一次运行就尤为重要。许多重要决策来自沉浸在数据中的研究人员:观看评估 rollout,凭借对整个系统的直觉来决定下一步怎么走。
从数据基础设施的角度看,评估和采集长得很像。你记录模型的输入、输出和目标,以及模型版本、子任务、环境配置等元数据。然后研究人员审查大量 rollout,按指标聚合,再下钻到具体的 recording。
把一个 rollout 追溯回导致它的训练数据,常常需要在互不相通的工具和格式之间手动做"侦探工作"。每一处摩擦都会累积成更慢的迭代周期,以及那些无法反馈到"训练出更好策略"上的洞察。
模型训练
机器人行为学习与其他机器学习任务共享许多基础。不同的是,这些模型随时间输出动作。这个新增的时间维度大幅增加了支撑训练的数据层的复杂性,关键原因有两个:样本构造和视频压缩。
训练中的样本构造
训练大模型时,我们必须以足够快的速度喂饱昂贵的 GPU,以最大化利用率。研究人员通过选择包含哪些数据、如何采样来操控模型的行为。
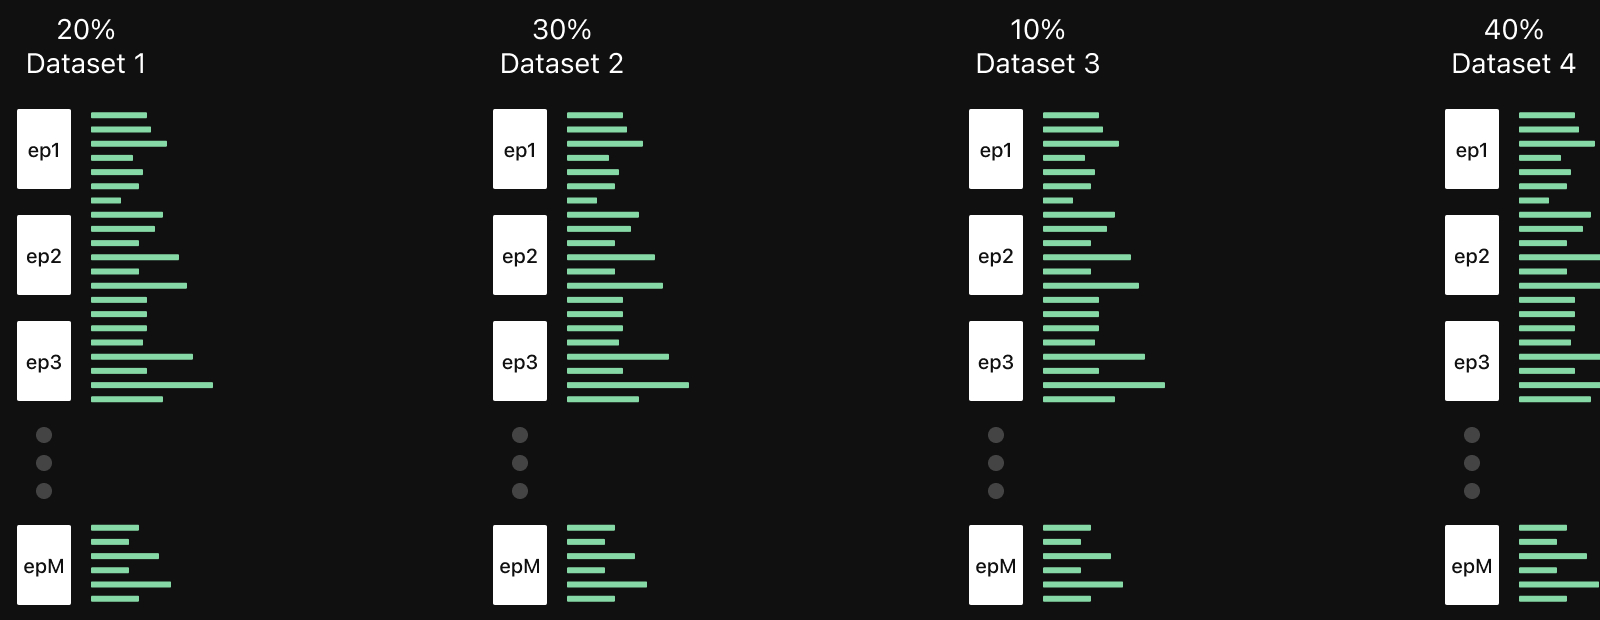
研究人员在训练模型时往往想把多个数据集组合在一起。常见的做法是对多个数据集做加权组合,有时甚至按时间步设置采样概率或 loss 的权重。
想想训练一个带动作分块的视觉-语言-动作模型(VLA),比如 ACT 或 pi0.5。一个人形机器人模型可能消费来自头部和腕部相机的三路视频流、30 多个关节的位置和速度、夹爪状态,以及一条语言指令。
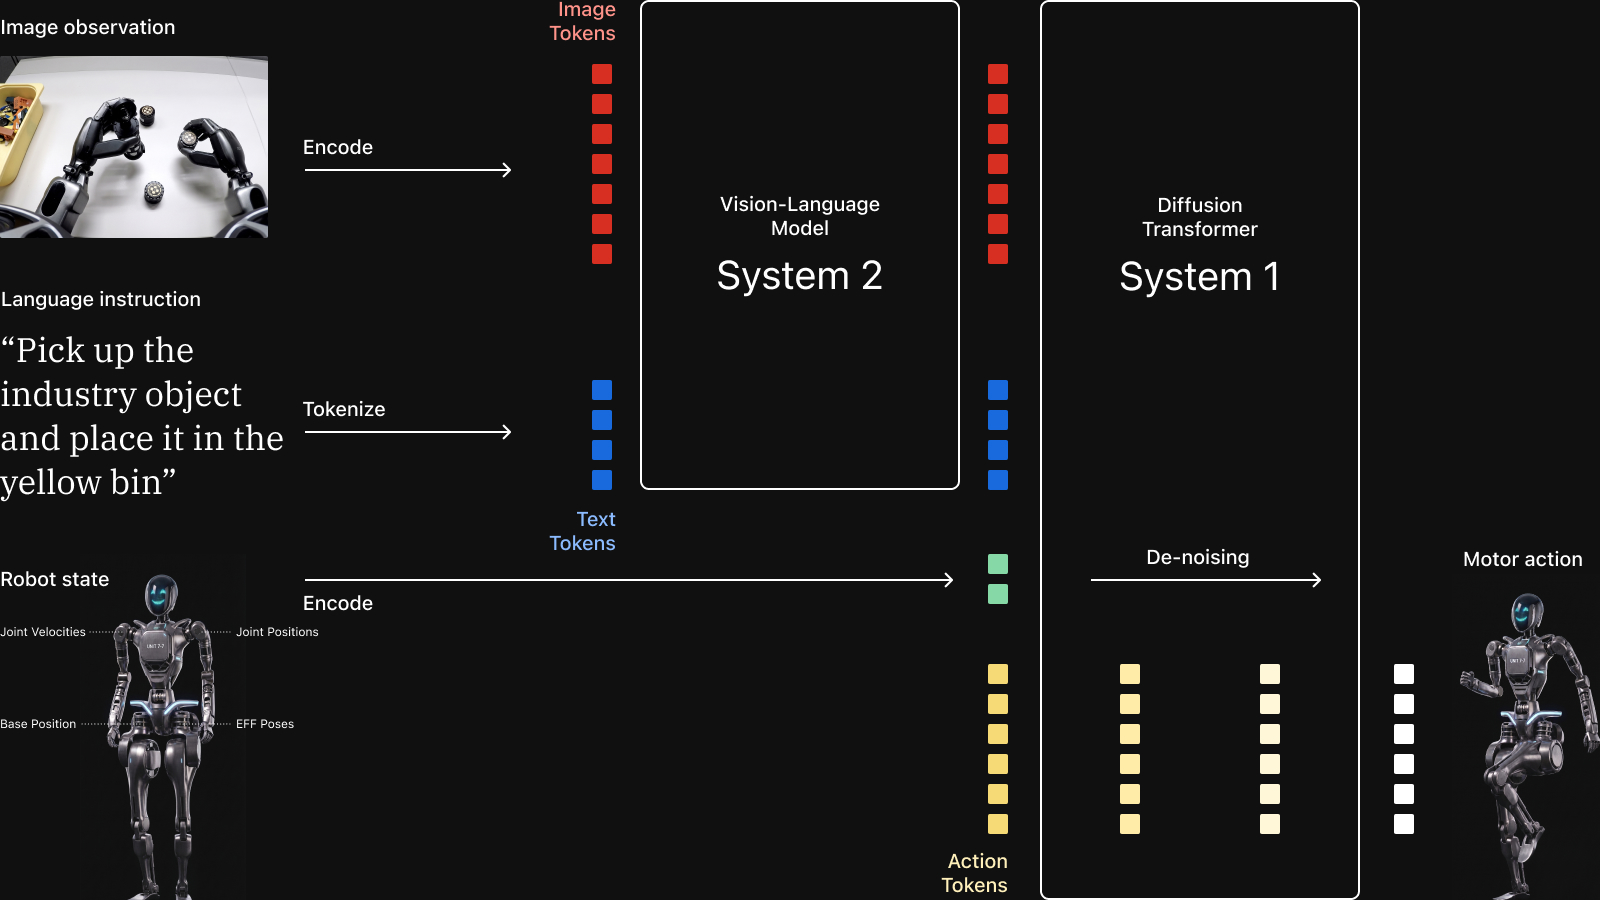
NVIDIA GROOT N1 模型的架构概览。
batch 中的每个训练样本,都从数据集中某个 episode 的单个时间步开始。对一个基本款 VLA 来说,样本本身由每个视角的相机帧、机器人当前状态和一段未来动作组成——通常是未来 50–100 个时间步。在机器人上录制和训练之间的某个环节,所有这些输入都需要时间对齐,这是一个常见的隐蔽 bug 来源。
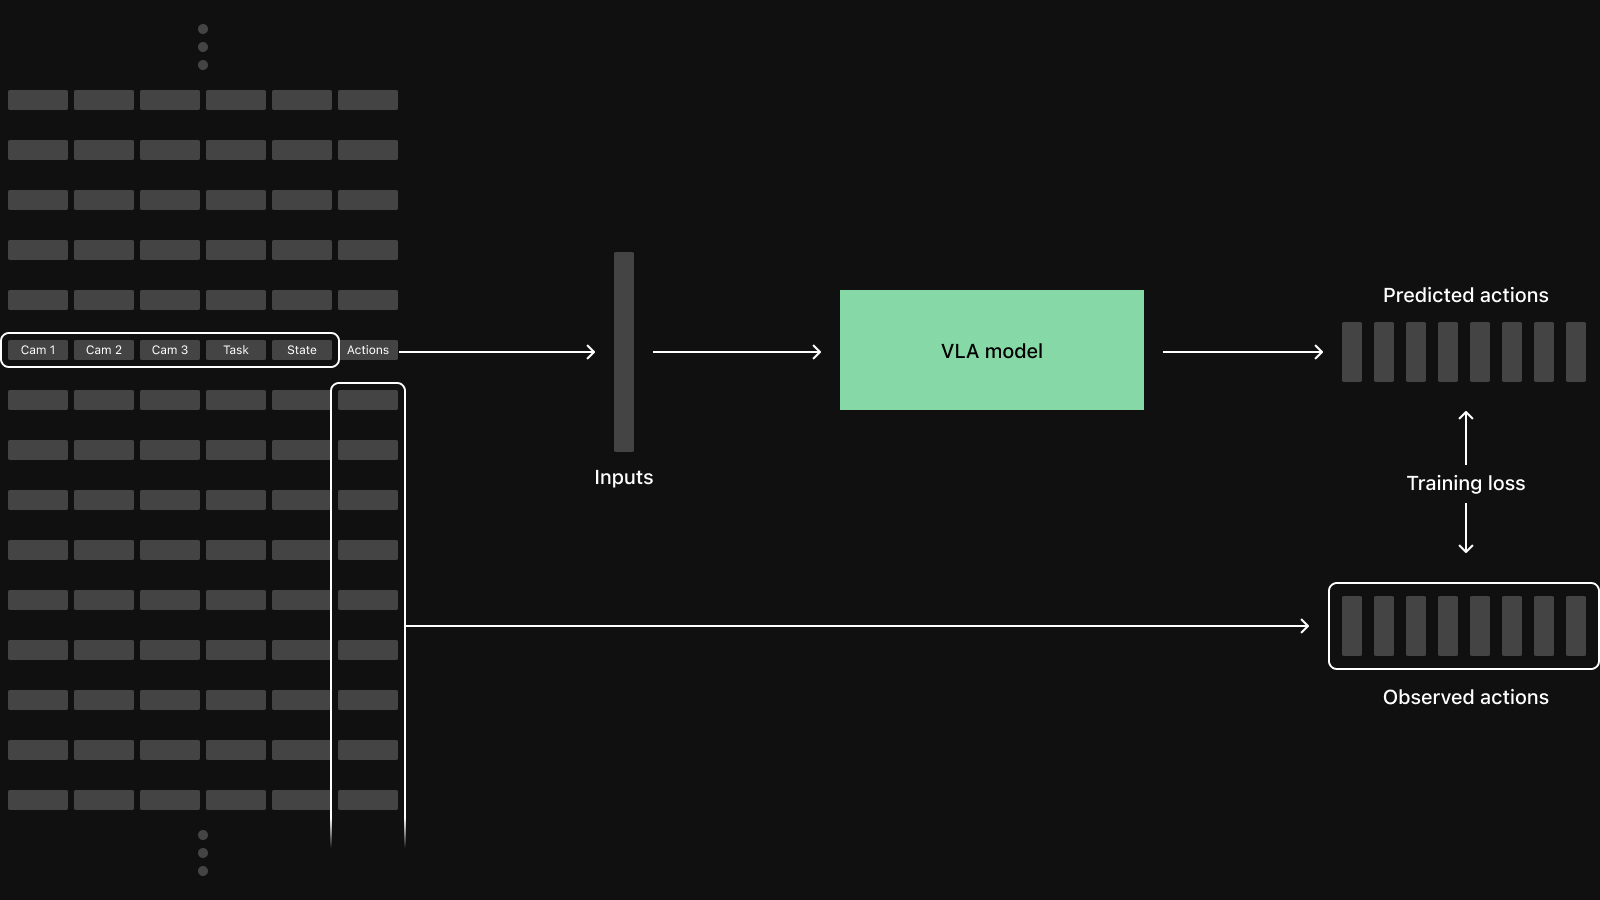
VLA 模型训练的基本样本构造。注意目标动作是从样本起点向前看取得的。
在这种情况下,朴素按行读取——读取所有时间步的所有列——会下载大量永远用不到的数据。一个高效的 dataloader 必须是列感知的:需要时取整行,否则只为一个时间窗口取特定的列。当数据集大到无法放在执行训练的机器上时,这种不必要的数据传输会导致 GPU 挨饿。
采样模式取决于架构,而且会继续演进。Diffusion Policy 以 2 帧观测为条件,预测未来 16 步。长程任务中的模型往往需要更长的历史,而且采样间隔可能不均匀。像 DreamZero 这样的 World Action Model(WAM)消费等间隔的连续帧序列,并联合预测未来的视频和动作。
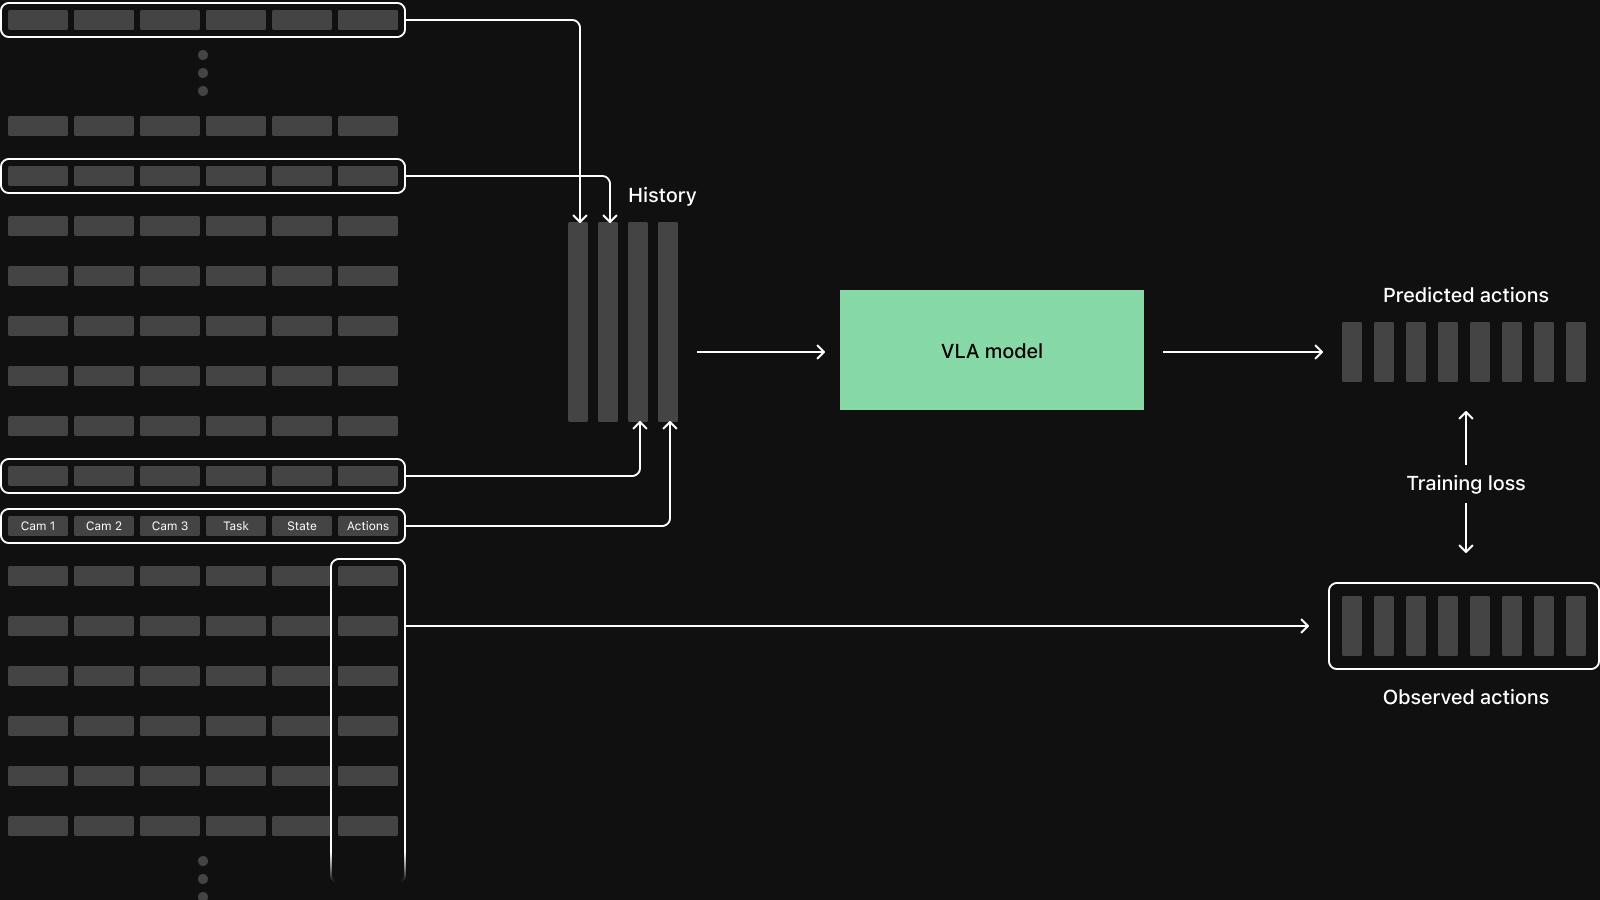
输入更长历史的 VLA 模型训练样本构造。
这些架构会继续演进,但我们始终在做的是组合多条数据流,去考虑单个观测该包含哪些传感器、哪些时间点。更复杂的采样模式也增加了隐蔽 bug 的风险,比如不小心混入了来自另一个 episode 的动作,悄悄拉低模型性能。
训练中的视频解码
视频常常占数据集总大小的 90% 甚至更多。把图像编码为视频利用时间冗余节省了大量存储,代价是复杂性增加。
大多数视频编码器并不独立存储每一帧。它们通过图像组(Group of Pictures,GOP)结构来利用时间冗余。一个 GOP 以关键帧开头,关键帧是一幅完整图像。随后的帧是增量帧(delta frame),存储相对于其他帧的变化。增量帧很小,压缩就是这么实现的。
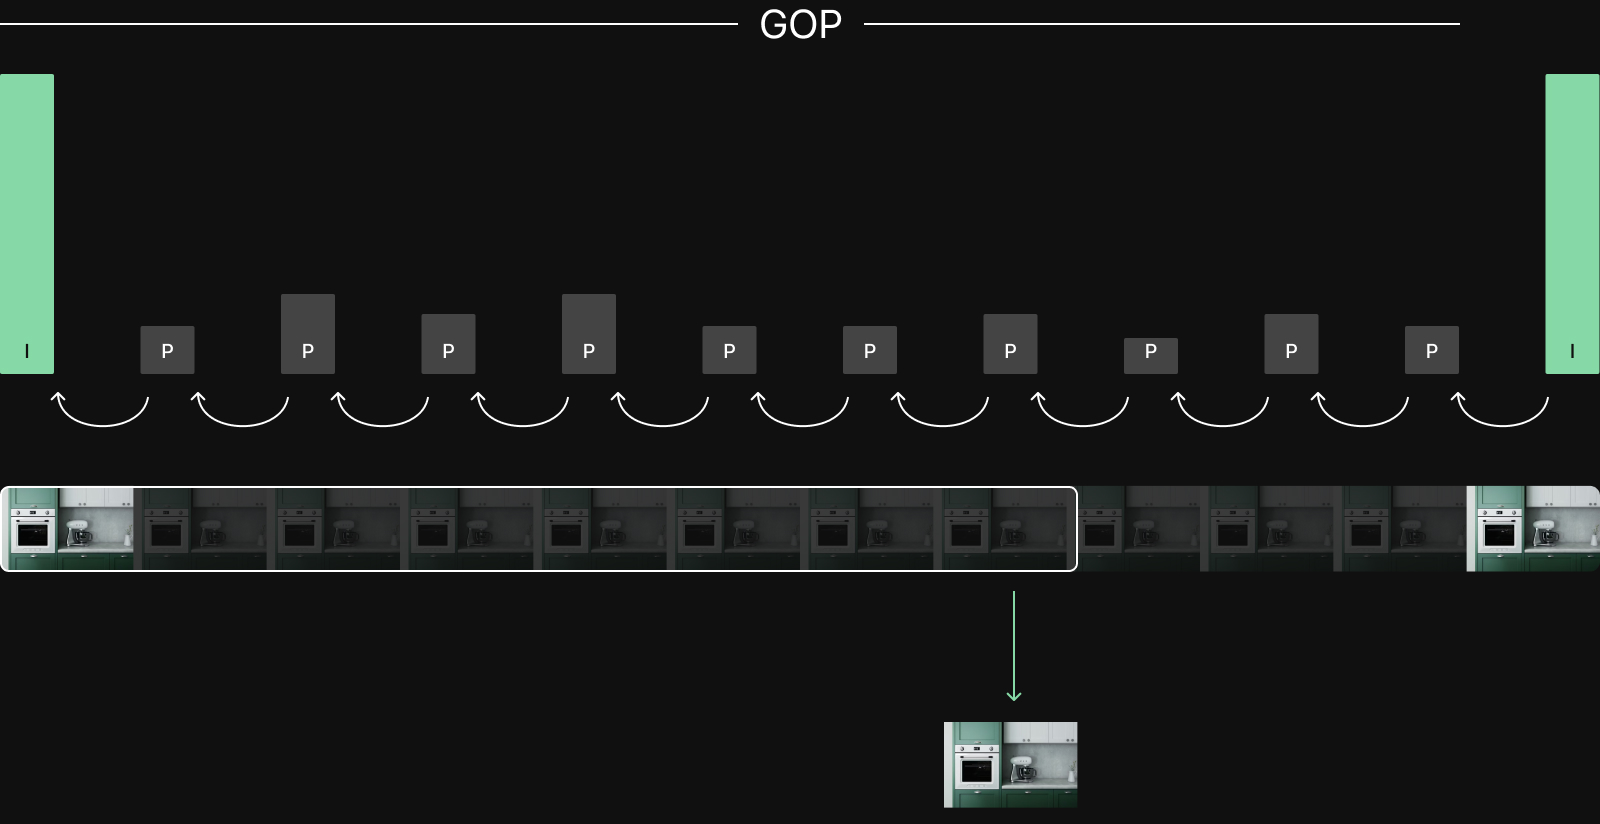
从 GOP 中间解码一幅图像的例子。本例中,解码器需要读取之前的关键帧(I-frame)和通往待解码帧的所有增量帧(P-frame)。
这对训练有直接的后果,因为模型需要完整的图像帧。要解码任何增量帧,解码器必须从最近的前置关键帧开始,把中间的每一帧都解码出来。典型的 GOP 为 30 帧时,随机访问一帧平均需要解码 15 帧才能得到 1 帧可用帧。
关键的权衡是 GOP 大小。GOP 越大压缩越好,GOP 越小随机访问越快。LeRobot 默认 GOP 为 2,每隔一帧就是关键帧,优先保证随机访问,但牺牲了潜在的压缩率。
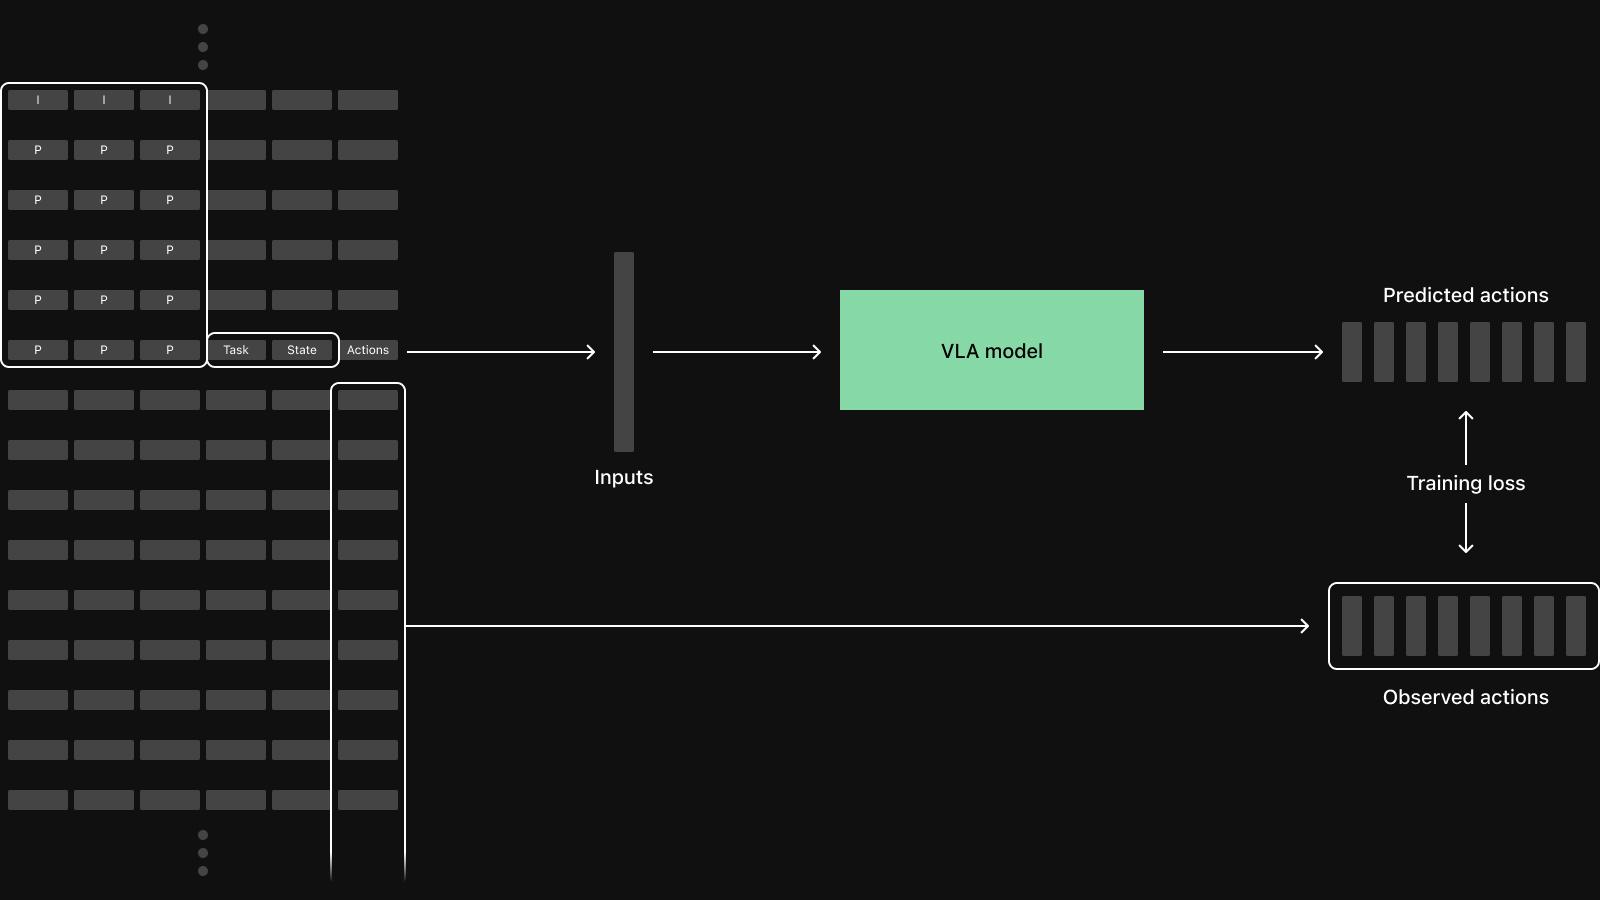
考虑视频压缩的基本 VLA 模型训练样本构造。图中每个标记为 P 或 I 的格子是一个编码后的视频包,即增量帧或关键帧。
说得更具体些:一个具有不均匀历史的策略——比如当前帧、上一帧、0.5 秒前、1 秒前——跨 3 路相机,每个样本就需要 12 次帧解码(4 个历史帧 × 3 路相机)。不均匀的间隔意味着这些帧可能落在不同的 GOP 里,每个都需要单独的 seek 和解码。无论哪种方式,数据取回逻辑都必须处理视频:要么 GOP 感知,要么取回整个视频文件。
dataloader 的复杂性转化为更慢的迭代速度
构建一个又快又正确的 dataloader 很难,对大到放不进训练集群的数据集来说更是难上加难。与此同时,很少有团队能接受糟糕的 GPU 利用率,这意味着他们会放弃灵活性,引入缓慢的数据导出任务来避免 GPU 挨饿。这里漫长的等待和缺乏灵活性,直接影响研究人员快速试验超参数和训练数据的能力,让数据集筛选和模型整体改进变得更难。
数据集筛选
让数据快速到达 GPU 很重要,但数据还得是对的。筛选(curation)确保数据集拥有优化模型性能所需的正确分布。HuggingFace 最近的机器人叠衣服项目发现,从 5,688 个 episode 的池中筛选出 1,200 个,把成功率拉动了 50 个百分点,而算法改进只拉动了 5–20 个百分点。然而,系统地改进数据构成很难,因为验证改进很慢。
数据质量
真实数据充满缺失的传感器流、schema 不匹配和录制缺口。QoQ 论文发现,DROID 数据集中 33.5% 抽样的笔类操作轨迹是完全失败的。抖动程度、速度分布、夹爪活动这类轨迹分析可以做进一步的过滤,而且容易编写——前提是数据接口合适。当机器人数据分散在视频流、关节状态日志和不同频率的动作录制中时,即便这种简单的分析也可能很困难。
大多数团队还会做大量肉眼审查。大量看数据是发现新问题、建立直觉的最好方式。对机器人来说,这意味着既要快速浏览,也要对多模态 recording 做深度下钻。
学习模型提供了更强大的分析能力。像 SARM 这样的 reward model 本来训练用于给任务进度打分,也可以用来给数据质量打分;而 DemInf 等方法估计每条轨迹对数据集状态-动作互信息的贡献。这些方法的运行成本更高,但目标是比人工审查更具扩展性。
在过滤之外,影响最大的质量改进之一是改进数据采集。经常审查数据的研究人员会注意到:操作员在某些情况下会犹豫、某些相机角度造成歧义、或者夹爪的接近动作不一致。改进采集设置对数据质量的提升,胜过任何数量的下游过滤。
数据集混合
数据集的构成对性能影响很大:包含哪些数据集、不同任务-机器人组合的权重如何、该强调什么、该弱化什么。Physical Intelligence 的 pi0 在自己的遥操作数据、仿真数据和开放数据集的混合上做了预训练,每个任务-机器人组合按幂律加权,压低过度表示的组合的权重。这篇 CoRL 2024 最佳论文表明,在每个任务的演示数量达到基线之后,增加任务多样性远比增加演示数量重要。如何构成混合,可能比拥有多少数据更重要。
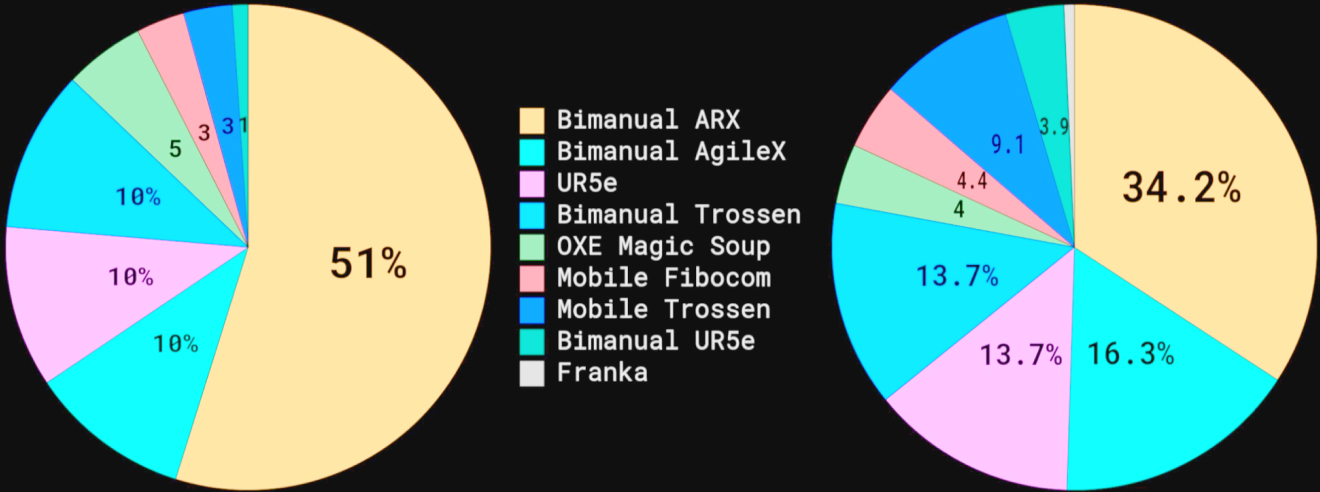
pi0 模型的预训练混合。右图展示了不同数据集在预训练混合中的权重,左图展示了它们以步数衡量的相对大小。
仿真让这个问题更尖锐。仿真数据生成便宜,因此很容易主导训练混合。但仿真到真实的差距意味着更多仿真数据并不总是更好,而要把比例调对,就得反复试验数据集的构成。
训练时指标——比如 loss 曲线和代理基准——即使在真实世界评估之前,也能给出混合是否有效的有用信号。团队本可以相对快速地迭代数据集构成,但如果 dataloader 不灵活,每个新混合都需要离线过滤和合并数据集、导出一个新副本、再把训练指向它。这笔开销给每次迭代都增加了摩擦,打击了系统性试验的积极性。
理想情况下,数据集混合应该被表达为一个查询:哪些数据集、什么权重、什么过滤条件。训练 dataloader 直接服务样本,无需单独的物化步骤;尝试一个新变体应该是改一个参数,而不是跑一遍流水线、复制一份数据集。
用标注与后处理增强数据
对基本的遥操作数据来说,从录制到训练之间的处理相对适度。团队会添加任务标注,按目标训练频率计算时间对齐的状态和动作列,并运行上面说过的质量检查。时间对齐很容易做错,做错会显著损害训练,但这些操作本身是定义明确的。运行上一节那些更强的筛选方法——比如 reward model 或生成 embedding 向量——需要大量算力来产出需要被集成的派生数据。
随着团队规模化、把目光投向遥操作数据之外,一件讽刺的事情发生了。端到端模型简化了感知栈,却需要如此多的训练数据,以至于团队被迫寻找更便宜、更可扩展的数据来源。
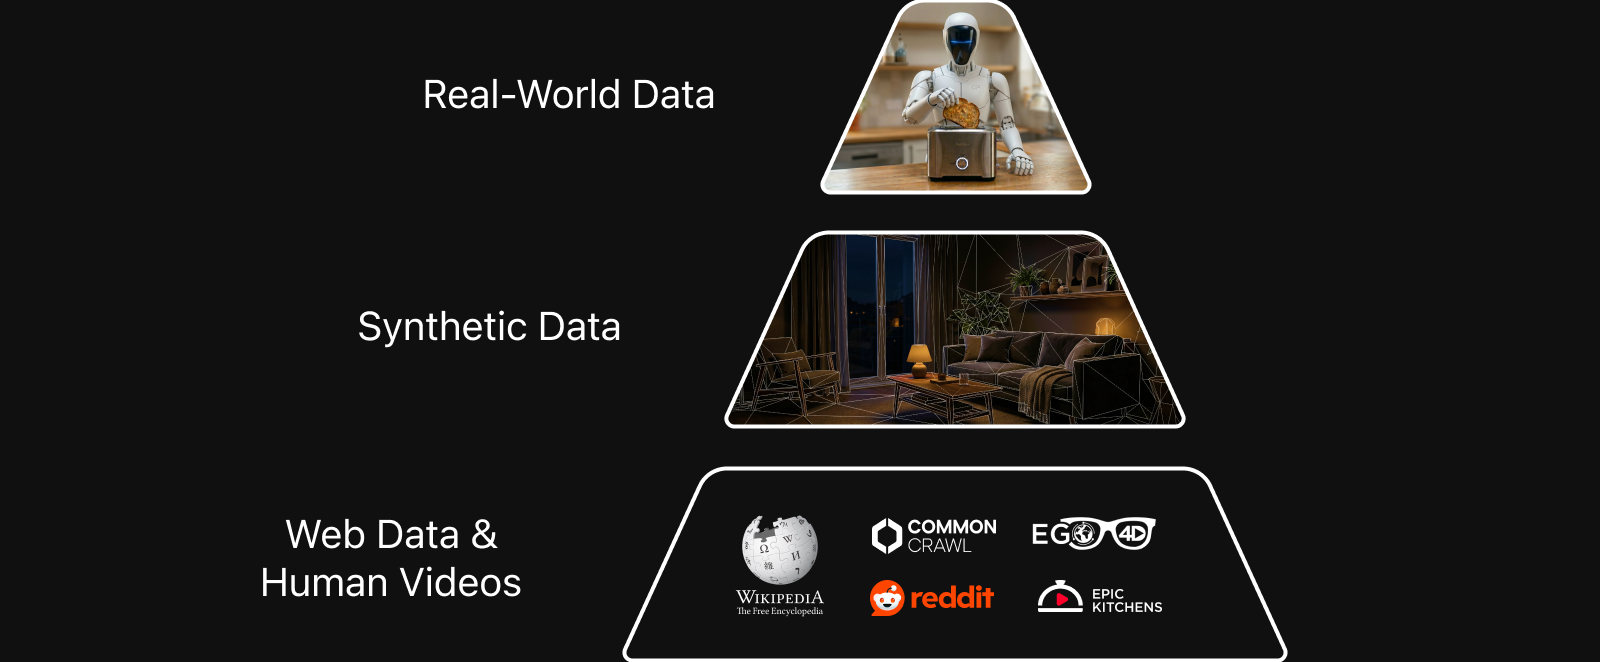
机器人学习的数据金字塔。真实机器人数据难以扩展,因此团队把它与其他数据来源结合起来,训练大型行为模型。
像 Sunday Robotics 和 Generalist AI 这样的公司,使用佩戴 UMI 式夹爪的人类数据采集员,比用真实机器人更快、更便宜地生成演示。要把这些数据变成可训练的东西,需要用 SLAM 从相机画面中提取物体的 3D 位姿,把人类动作重定向到机器人运动学,并验证空间一致性。Generalist AI 报告在这些流水线上使用了 1 万多个 CPU 核心。复杂性并没有消失,它只是从机器人推理转移到了数据流水线。
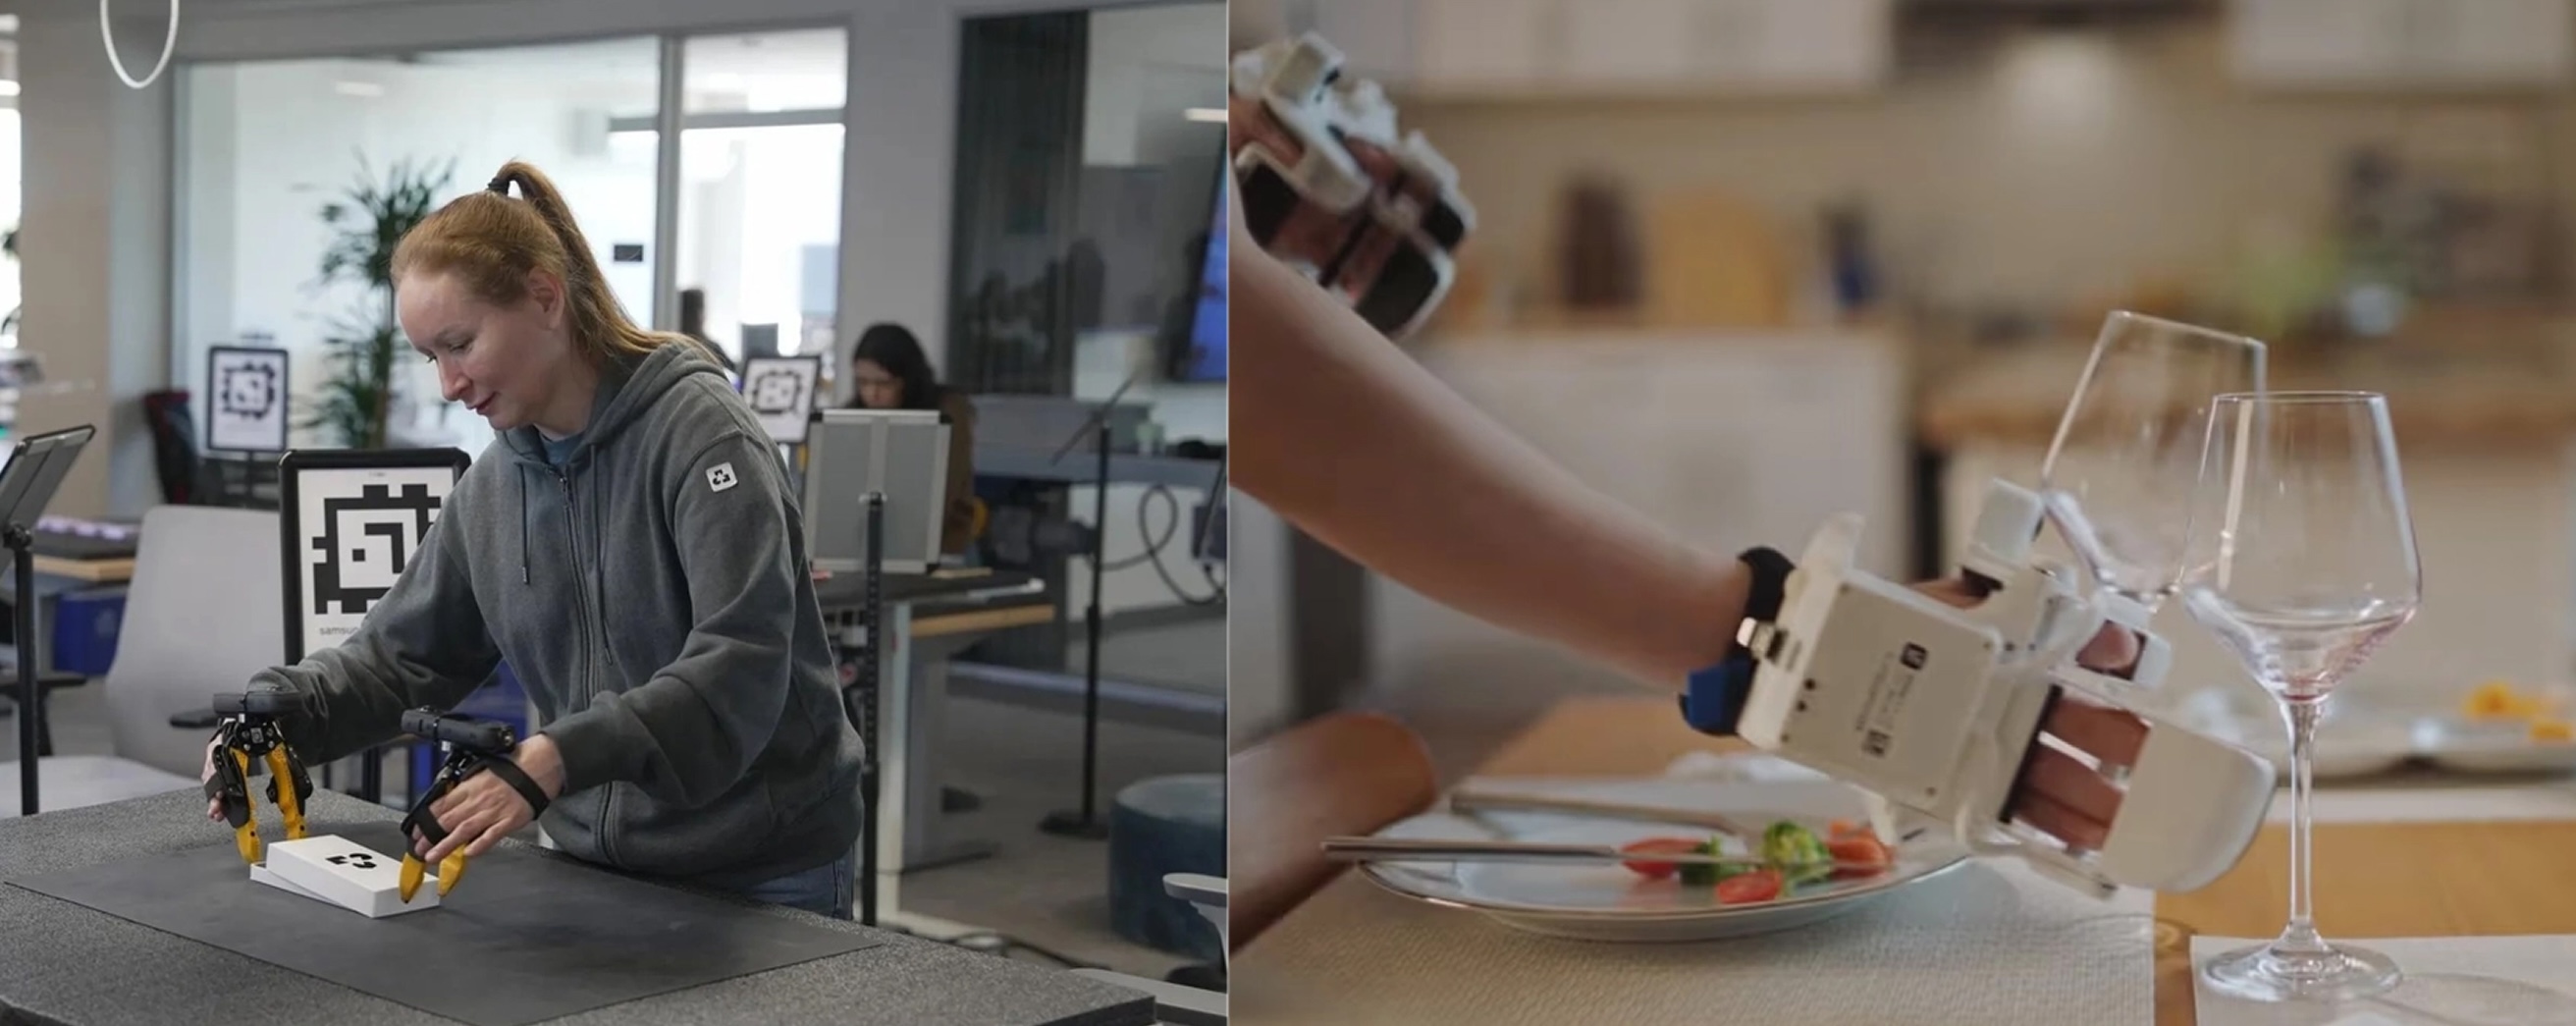
用专门设计的手持设备进行数据采集。左:Generalist AI 的夹爪,背景可见 AprilTag。右:Sunday Robotics 的 Skill Capture Glove。
纯第一人称视频(来自头戴相机)需要更多处理,因为录制的动作是人类的手而不是夹爪,而且相机视角需要映射到机器人的视角。
Meta 的 HOT3D 数据集提供了来自 Quest 3 和 Aria 头显的稠密 3D 手与物体追踪。
团队还用 3D 重建来增强现有数据集。特斯拉使用自研的 Generative Gaussian Splatting,从多路相机画面重建完整的 3D 场景,为 FSD 和 Optimus 生成真实世界录制的合成变体。
所有这些处理都要读取源数据、计算派生信号,并以可能与源数据不同的频率写回结果。端到端学习从机器人身上移除的复杂性,正在数据流水线里重新出现。如果数据层不能原生地建模和存储多速率、多模态数据,管理和调试这些流水线的复杂性会迅速膨胀。
记录、摄取与规整
每台机器人、每个采集装置都不一样,所以团队不可避免地构建定制方案。遥操作与具体机器人紧密耦合,因为低延迟控制要求直接的硬件集成。云端推理或在线强化学习则是完全不同的录制架构,数据可能根本不经过机器人的本地存储。把这些系统建好很重要,因为它们决定了下游能用什么数据。
挑战从摄取就开始了:把所有这些规整成可用的东西。即使同一个团队使用同一种录制格式,schema 也会随时间漂移。新增一个传感器、关节命名规范变了、录制软件更新导致字段挪了位置。六个月前采集的数据和今天采集的数据结构可能不同,而两者需要能一起用于训练。
在更大规模下,团队要组合来自多种机器人配置的数据,每种都有自己的惯例。Open X-Embodiment 需要 60 多个由不同实验室贡献的定制数据集转换构建器。把 DROID 这样的大数据集在格式之间转换一次,可能要花好几天。
把所有这些变成可查询的共同形态,是让下游每一步成为可能的根基。脆弱的流水线在全栈调试时尤其痛苦。你在评估中发现不对,回溯穿过训练和筛选,最终发现问题出在源数据的摄取方式上。团队需要一个用于这种数据整理工作的框架,以及一个易于引入新数据、又不破坏已有数据的共同格式。
一个有先例的权衡
在分析领域,团队花了多年时间为同一数据的不同消费者维护独立的系统。数据湖把所有东西以开放格式便宜地存起来,但缺少支撑可靠查询的结构。数据仓库提供快速、结构化的查询,但要求严格的 schema,并把数据锁定在 ML 工具读不了的专有格式里。于是团队两者都跑,在两者之间做 ETL,还常常为 ML 负载再导出一次——造出多个副本,schema 不同、新鲜度不同,连接它们的流水线脆弱不堪。Lakehouse 架构通过在对象存储的开放文件格式上直接加一个结构化的元数据层(事务、schema 强制执行、索引)解决了这个问题。一份数据,BI、分析和 ML 都能直接访问,不需要独立系统或冗余的 ETL。
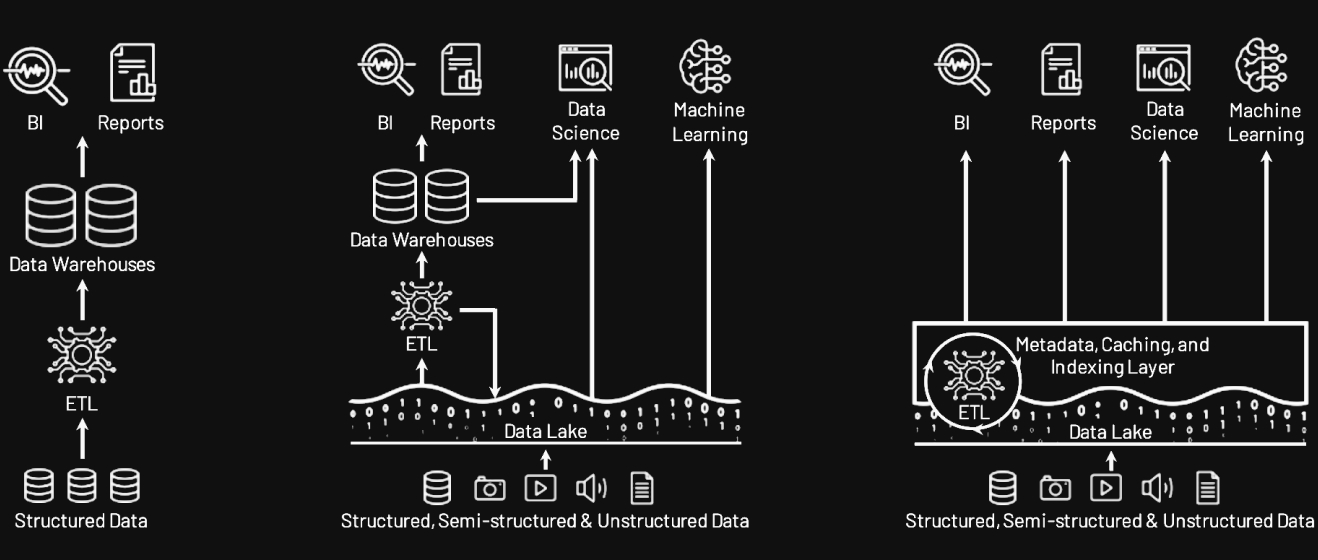
原始 Lakehouse 论文中的图,关于从两层模型到 Lakehouse 模型的演进。从左到右:仅仓库、仓库 + 数据湖、Lakehouse。
机器人数据基础设施正卡在同一个权衡的自家版本里。基于 MCAP 等日志格式的文件处理非常适合录制和回放,但对大规模查询和训练不切实际。像 LeRobot 那样早期规整进固定 schema 能让你快速开始训练,但锁死了日后改动代价高昂的决策。从分析领域借来的"每个 topic 一张表"的做法允许延迟规整,但当多个系统需要把它们重新 join 回去时,复杂性就会爆炸。团队最终维护着同一数据的多种表示,以及转换它们的流水线。
在此之上,物理 AI 数据还需要在每个阶段都可视可查。研究人员靠看轨迹而不是读表格来建立直觉。如果数据层不能原生地提供可视化,它就变成了又一个消费者:有自己的格式要求,有自己的转换流水线。
每种方案都解决了问题的一部分,又在其他地方制造摩擦。随着团队的 dataset 规模、来源多样性和筛选精细度增长,这些摩擦会复利累积。
数据层税
不成熟的数据层最显眼的成本,是花在格式转换、定制 loader 和流水线胶水代码上的工程时间。但真正的成本是那些永远不会发生的工作:是那些因为每次都要全量导出数据、而不是改一个参数,而慢到不值得尝试的数据集混合;是因为数据不可查询而无法规模化应用的筛选方法;是因为可视化只覆盖录制阶段而未被察觉、悄悄溜进训练的变换 bug;是因为工具互不相通、要花好几天才能追溯到采集问题的评估失败。在错误的地基上做研究,感觉就像在泥里摸黑走路。
在机器人学习中,你通过闭环来构建适应性强且可靠的模型:记录、分析、训练、部署。获胜的团队会比其他人更快、更精准地转动这些闭环。而他们不会建立在一个对每一步都征收重税的数据层之上。
过去几年,Rerun 一直在从零构建解决这个问题的各个部件。我们正准备把它分享给世界。如果你认出了本文中的这些问题并想了解更多,欢迎联系。
原文:The data layer tax for robot learning · 作者:Nikolaus West · 发布于 Rerun Blog,2026-04-30
相关文章:机器人学习的新数据层(译文) · Rerun 官网