机器人学习的新数据层
译文说明
原文:A new data layer for robot learning,作者 Nikolaus West(Rerun 联合创始人 & CEO),发表于 Rerun 博客(2026-05-13)。译文仅供参考学习,一切图像与视频素材版权归 Rerun Technologies AB 所有。
物理 AI(Physical AI)将重塑整个物理世界的产业,但机器人领域仍然缺少一个能以现代 AI 所需速度支撑迭代的数据层。核心挑战在于:机器人学习处理的是物理数据——与时间、空间和本体绑定在一起的多模态、多速率数据流。现有的基础设施大多是围绕 Web 数据构建的,难以应对这些特性。
在 Rerun,我们正在为物理数据构建一个统一的数据层,帮助团队为真实世界训练和交付智能。
Rerun 有史以来最大的一次发布
Rerun 最为人所知的是多模态时序数据的可视化。而在过去一年半里,我们一直在低调地构建统一数据层的其他部分,以支撑从数据采集到训练的完整旅程。随着 0.32 版本 Rerun SDK 的发布,这些能力正式开源!
这是 Rerun 三年前首次开源以来最大的一次发布,极大地扩展了 Rerun 可以胜任的工作范围。
我们正在稳定文件格式,并为文件新增一套更低层级的读写 API。我们新增了用于操作 Rerun 数据 chunk 的 API,专为清洗和规整真实机器人数据而设计。我们扩展了 MCAP 和 ROS 2 消息支持,让开箱体验更好。我们新增了数据集审查 UI,让训练数据集的审查速度快得多。开源的 catalog server 现在可以直接索引磁盘上的 .rrd 文件,你(或你的 agent)可以对整目录的机器人 recording 编写通用查询。在同一套基础之上,我们还发布了 PyTorch dataloader——你可以直接在 .rrd 文件上训练机器人模型,无需导出到任何训练专用格式。
机器人学习生态一直缺少一个灵活到足以支撑机器人学习数据全生命周期的统一框架。0.32 让这一基础开始成形。
除了这次大规模开源发布,我们还宣布了商业产品 Rerun Hub——数据 catalog 与存储引擎。Rerun Hub 现已进入 private preview,它将 Rerun SDK 扩展到由对象存储支撑的数据集之上。它提供了一个共享的 catalog 和访问层,用于在更大规模下转换、查询、可视化和流式传输机器人数据,同时保持相同的数据模型和 API。
如果你的目标是把数据规模扩展到超出单台机器的限度,并且还想保持快速迭代,那就该用 Rerun Hub。如果你是一个围绕机器人学习构建产品的团队,正在考虑自己的数据层,欢迎联系。
本文剩余部分分两块:首先是一份入门读物,介绍我们认为物理 AI 规模化所需的数据架构;其次是一次巡礼,看 Rerun SDK 0.32 中把这套架构落地的新能力。
机器人学习需要一个为物理数据而生的数据层
正如《机器人学习的数据层税》(英文原文:The Data Layer Tax for Robot Learning)一文所述,拖慢物理 AI 进展的大量摩擦,来自强迫物理数据穿过为传统软件和分析负载设计的基础设施。真正需要的是为多速率、多模态数据构建的数据层,它能支撑改进机器人智能所需的全部工作:采集、训练、部署,一个不缺。
Coding agent 意味着用户必须完全掌控计算层和应用层
要支撑采集、规整、后处理、数据筛选和训练的完整工作流,团队需要各种不同的工具和计算任务。这些工具和任务编码了团队的特定工作方式,或团队用于规模化驱动数据质量的技术,因此是团队差异化的关键所在,必须由团队自己掌握。
只要具备代码级的控制力,coding agent 正在让团队完全按自己的意愿设计这些工具和计算任务变得越来越可行。正因如此,几乎没有团队能接受失去这种控制。这就是为什么 Rerun SDK 完全开源,并且被设计成一个可以与之共建的框架,而不是一个围墙花园式的 SaaS 平台。甚至 viewer 也是被设计成一个库,你永远不会被卡死。Rerun 从来都是代码优先,并且我们一直在加倍努力让它对 agent 更加易用——这甚至包括即将推出的完全无头渲染和 viewer 导航能力,帮助 agent 像人一样"看见"物理数据。
大多数团队其实已经在构建定制的一次性应用和处理脚本,以适配自己的工作流。如果不建立在坚实的基础之上,你最终会得到一堆垂直的、难以理解且不好组合的单件,生产力的提升也就此封顶。
数据层必须扛住使用大规模物理数据的那些硬骨头
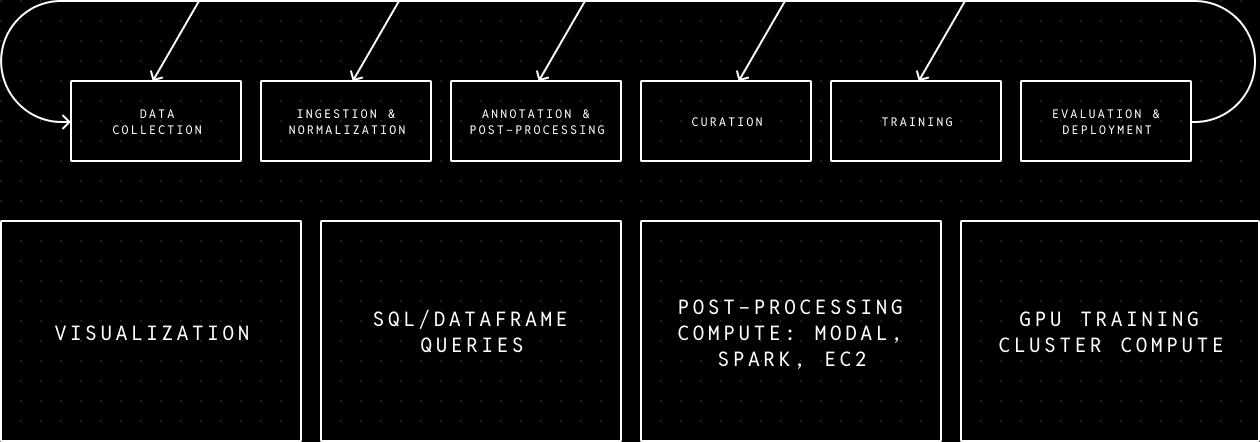
机器人学习工作流的每个环节,都依赖同样少数几种计算与应用能力:可视化、查询、后处理和训练。底下的数据层必须把它们全部服务好。
要支撑从采集到模型的完整数据旅程,核心能力就是可视化、分析型查询、转换和训练。所有这些能力都必须处理多速率、多模态、可能携带 3D 关系或形状等机器人语义的数据。为了避免 bug 和数据不一致,你希望这类数据的种种微妙之处在任何使用场景下都被一致地对待。比如,时间对齐和 3D 变换应该在预处理、查询、可视化和数据集审查中行为一致。
要让数据-实验循环和支撑它的工具都容易迭代,你需要建立在单一统一数据层之上,让交接变得 trivial、上层的应用变得简单。这意味着数据层必须足够灵活,能承载来自所有核心应用和计算能力的需求。例如,可视化和计算都要求对多模态时序数据的快速随机访问,分析型查询要求高效的列扫描,而大规模后处理计算(CPU)和训练(GPU)都要求高带宽的并行数据流。
物理数据的表现从根本上不同于 Web 数据和业务数据,这意味着它受益于不同的存储和查询抽象。
物理数据的核心存储单元是 column chunk(列 chunk)
物理数据有两个与众不同的特性:
第一是多速率:不同传感器以截然不同的频率记录数据。GPS 可能是 1–10Hz,相机 10–30Hz,关节角度 100–200Hz,IMU 1kHz。在后处理中,你可能每 10 帧相机图像算一次语义 embedding,或在每个 episode 的起点和终点生成场景描述。
第二是多模态:不同传感器记录的数据大小天差地别。IMU 和 GPS 只需要几个字节编码几个数值,而一帧 RGB 相机图像可能就要好几 MB。
如果你把一段机器人 recording 存进一张"一行代表一个时间戳、一列代表一条数据流"的表,多速率特性会让这张表非常稀疏——对任何一行来说,大部分列都可能是空的。多模态特性则造成巨大的内存不均衡,因为单行里不同单元格的大小可能相差几个数量级。现有的表格式数据基础设施很难同时应付这种组合。
多速率、多模态数据应该被存进 chunk:每个 chunk 持有数据集的一个行子集和列子集。这样一来,比如你可以把一百万个 IMU 样本放进一个 chunk,而把寥寥几个视频包放进另一个 chunk,稀疏性和内存不均衡两个问题就都解决了。
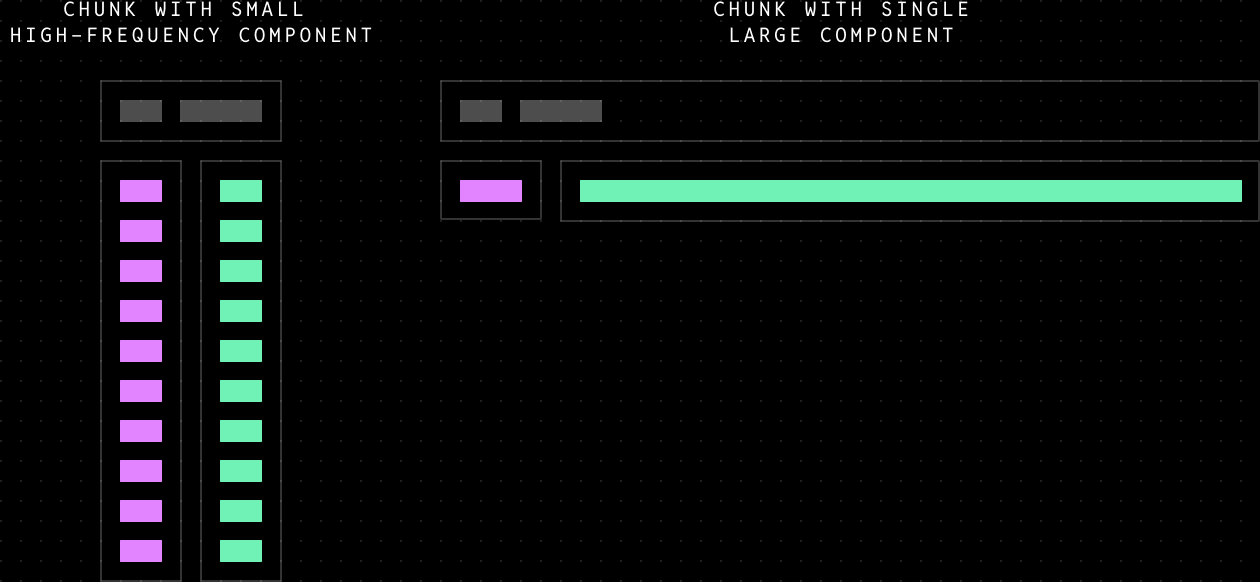
两种形状的 chunk:左边的高 chunk 装大量行的小体积高频数据,右边的矮 chunk 装单个大组分比如视频帧。不同的形状让每个 chunk 在磁盘上大小大致相当,而不管底层传感器是什么。
在 chunk 内部,列式存储优化了压缩和列扫描查询,而行式存储优化了简单写入。
在 Rerun,我们相信 column chunk 是机器人学习数据系统的最佳权衡,并已将其标准化为我们架构的核心存储抽象。
Rerun 的 .rrd 文件格式就是围绕 column chunk 构建的
Rerun 的原生文件格式 .rrd,是 column chunk 抽象在磁盘上的表示。在内部,每个 column chunk 被编码为一个 Apache Arrow record batch,外加描述数据应如何解释的语义元数据。Apache Arrow 是数据科学领域的事实标准,使用 Arrow 意味着我们有一条通往 DataFusion、Pandas 和 Polars 的快速零拷贝通路。
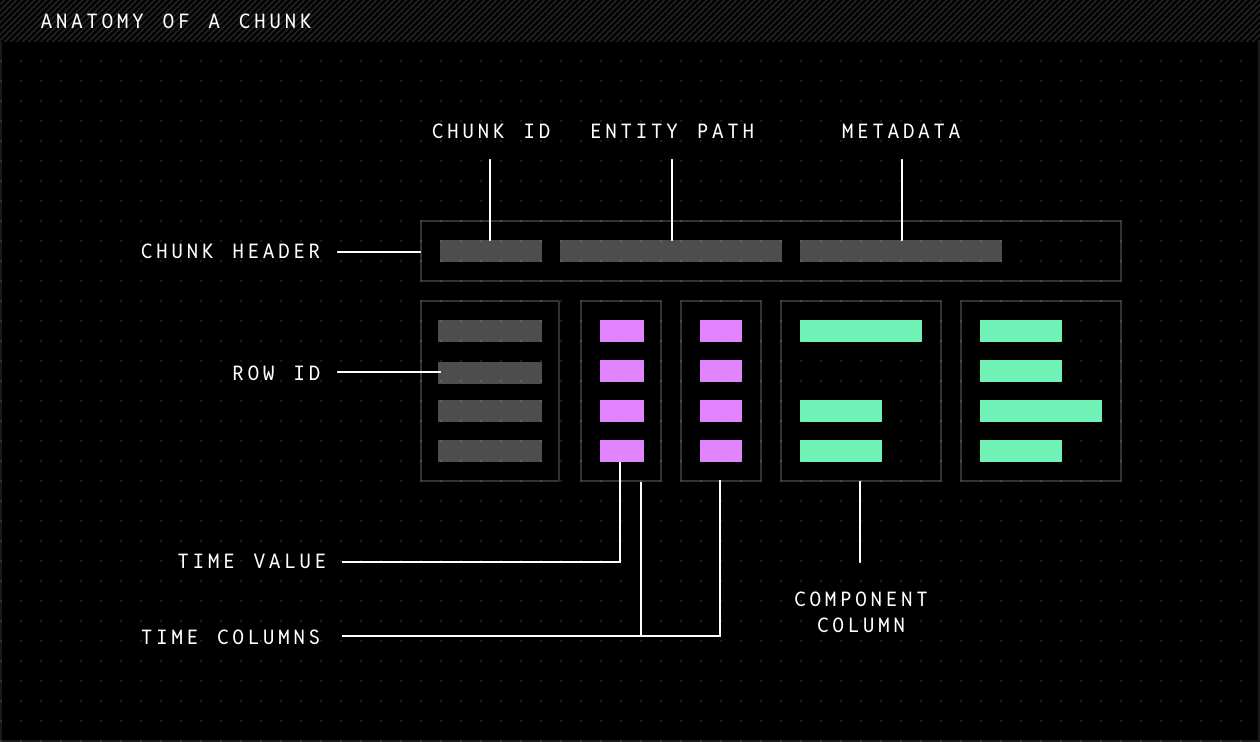
chunk 的内部:一个小头部(chunk id、entity path、元数据),之后是 row id、时间列和若干个组分列。所有数据都是列式的 Apache Arrow 数据。
每个 chunk 中的元数据包含如何解释数据的语义信息("这是一个 IMU 传感器,这是一个 GPS,……"),因此数据在处理管线中流转之后,仍然可以被自动解释和可视化。
编码后的 column chunk 被包裹进 protobuf 消息并串联起来,形成一个 .rrd 文件。文件末尾的 footer 指向一个索引,使得无需扫描整个文件就能快速随机访问单个 chunk。
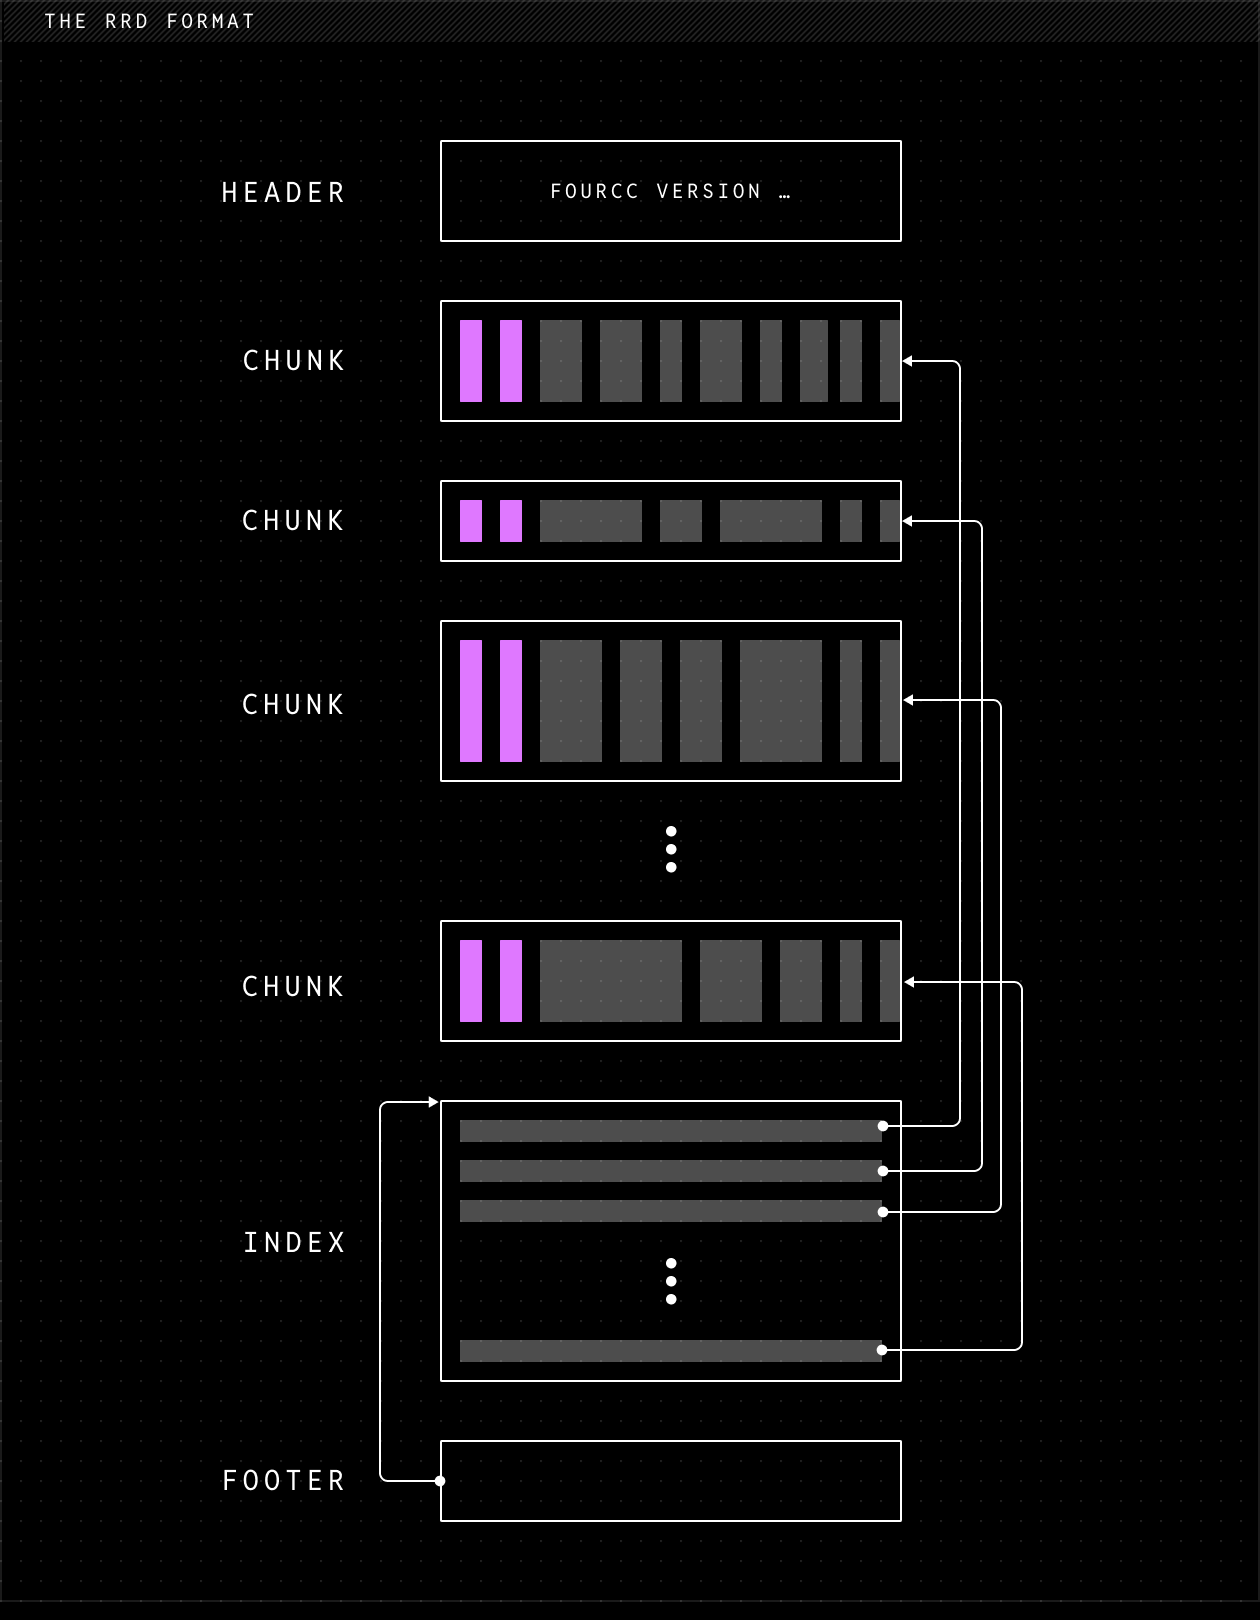
一个 .rrd 文件就是一串 column chunk,后跟索引和 footer。索引中每个 chunk 占一行,记录其字节范围、schema 和时间范围,查询因此可以直接跳到所需的 chunk。
与其他格式的对比
Apache Parquet 是一种列式磁盘格式,通常与 Arrow 搭配使用。它把数据组织进 row group,但与 .rrd 中的 chunk 不同,这些 row group 不能重叠:每个 row group 都包含所有列在一个稠密行区间上的数据。这使它不适合多速率、多模态的机器人数据。你可以追加新行,但不能追加新列(没有 schema 演进)。
MCAP 是一种在机器人上记录机器人日志的格式。它的设计目标是写入快速灵活,并有很强的 ROS 兼容性。然而它本质上是不透明消息(用 JSON、protobuf、CBOR 等编码)的容器格式,并未针对列式分析查询优化。大扫描和大 join 很慢,因为你需要逐条解码消息。
Lance 是一种新格式,明确为多模态数据和随机访问(这对训练极其重要)而构建。与 Parquet 不同,它支持 schema 演进。但 Lance 数据集仍然是行对齐 fragment 的垂直堆叠,多速率流会被 null 撑得膨胀。
NCore 是 Nvidia 推出的新格式,为神经重建而构建。多速率通过按组分的时间戳原生支持,空间对齐通过位姿图(pose graph)支持。但它的 schema 是封闭的(规范化的传感器组分,而非任意用户自定义数据),基于 Zarr 而非 Arrow 原生,也不是为了服务通用的 SQL / dataframe 查询引擎而构建的。
你的团队需要的每一项功能,只要文件格式不提供,就意味着多一条要保持同步的管线,团队要多学一个工具才能成功。Rerun 的格式是唯一能够服务"把机器人 recording 转化为智能"所需的全部用例的选项。它让你保留数据原始的时间戳,同时仍然能从同一数据源查询、查看并流式传输给训练。它有足够的结构来在其上构建统一的数据系统,又足够灵活,可以为不同的读写模式做优化。
在 column chunk 之上加一个索引、schema 和元数据层,让大规模使用物理数据变简单
为了分析单个信号而扫描数据集里的所有 chunk,即使对很小的数据集也扩展不动。所以要有效使用它们,你需要一个元数据和索引层,能为任何查询找到正确的 chunk。这看起来非常像经典的 data lakehouse 模式。在我们的场景中,单个数据集或 recording 由异构的 chunk 组成,这些 chunk 并不共享相同的 schema。而经典数据处理工具是为处理 schema 统一的表而构建的。因此,面向物理数据的 lakehouse 式索引和元数据层,还需要跟踪这些单独的 schema,以便能够即时物化出任意数据流的合并 schema,让经典数据工具可以工作。举个例子:如果你把 IMU 升级成一个会在消息里发布磁场数据的新型号,这一增量与你旧的、不含这个字段的 IMU 是兼容的,不需要为了兼容性重写历史数据。
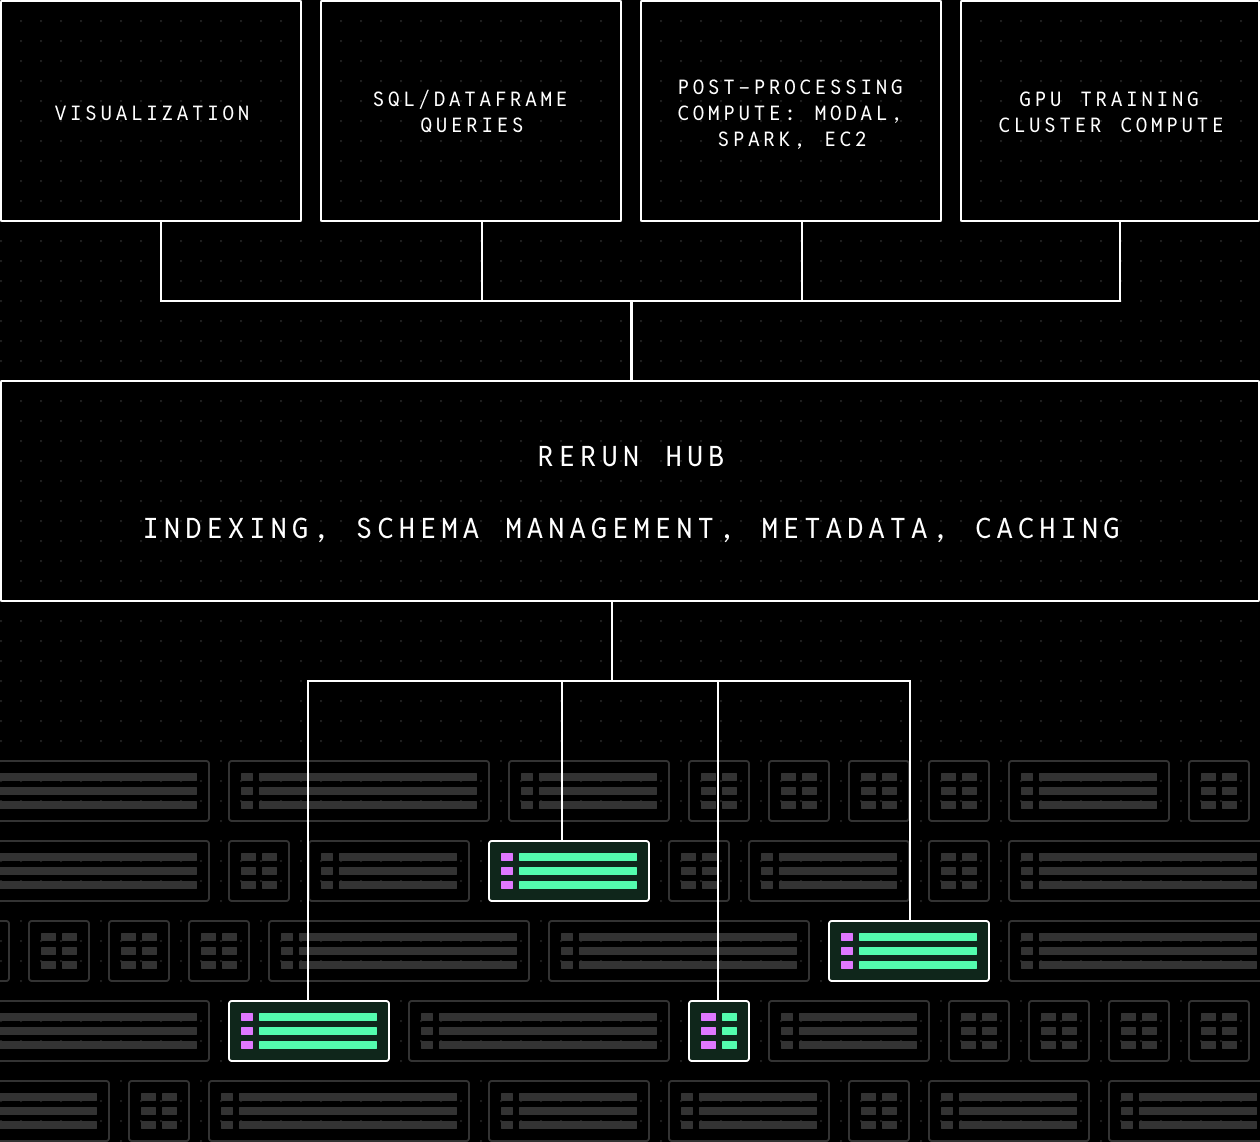
Rerun Hub 把异构的 chunk 池变成应用层可以当作统一数据集来对待的东西:即时物化合并 schema,只为每个查询拉取所需的 chunk。
column chunk 配上高效的索引,让你只取需要的数据,而不必为存放在旁边的无关数据流付出代价。你不必在"让常见操作变快"和"能追查长尾 bug"之间做选择——因为后者要求你把常用数据导出到另一个数仓。
除了性能收益,这一层还让我们得以把文件抽象掉,为上层所有物理数据用户呈现一个统一的 API。机器人数据常常存在一个文件里,标定数据存在另一个文件里——把这些实现细节抽象掉,是减少数据摩擦、简化计算与应用层的重要一环。
大规模处理与训练要求直接从对象存储中选择性流式读取
机器人学习数据集已经可以达到非常大的规模,并且随着团队沿着 scaling law 去追求越来越强的模型,还会变得更大。要处理这种规模的数据,你常常需要把任务扇出(fan out)到大量 CPU 上做后处理,或大量 GPU 上做训练。在这些场景下,数据吞吐必须能随计算的需求扩展。
无论是为了最大化性能还是最小化出站流量成本,你都希望计算在数据附近运行。同时 GPU 算力又很难搞到,许多团队最终不得不在不同地点租用。所有这些因素叠加,意味着你需要能够把存储与负责索引和元数据的服务分离开。
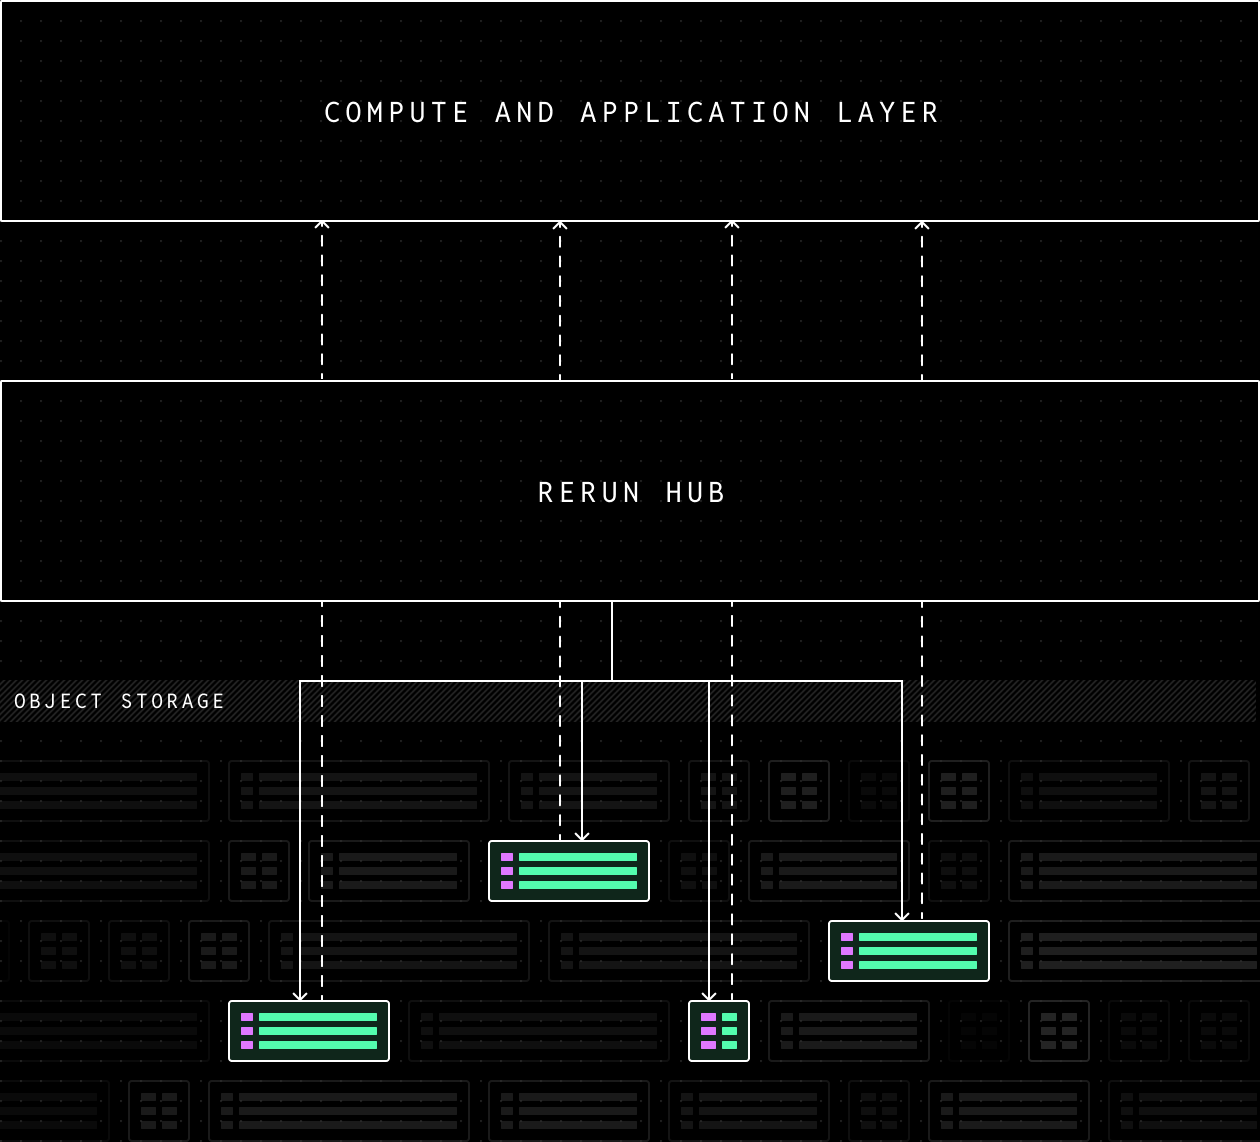
计算与存储独立扩展:Rerun Hub 只为每个任务从对象存储中直接取它需要的 chunk,因此你可以跨 CPU 或 GPU 扇出,而不用搬动数据。
在 Rerun 中,查询从 Rerun SDK 发起,SDK 再查询 Rerun Hub,由 Hub 负责弄清楚解析该查询需要哪些 chunk。根据设置的不同,SDK 要么通过 Rerun Hub 中的缓存代理来请求 chunk,要么请求对象存储上的字节区间。这使得访问 API 得以简化,支持选择性 chunk 流式传输,并能从底层对象存储获得最大的流式带宽。
Rerun SDK 0.32:机器人学习的统一数据工具箱
Rerun 0.32 是 2023 年 2 月首次开源以来最大的一次发布。它把 SDK 的实用场景从记录(logging)、可视化和较简单的查询,扩展到从采集到训练的完整数据旅程。下面逐一巡礼这次扩展带来的新特性,更多细节见 release notes。
稳定的文件格式与 chunk 级 Python API
在 Rerun 0.23 中,我们宣布了 .rrd 文件格式的版本间向后兼容。实际上,从那以后我们没有破坏过任何版本之间的兼容性,现在我们有信心承诺文件格式的通用向后兼容。我们会继续演进格式以推进能力和性能,但旧数据将永远可以加载。
在 0.32 之前,你只能通过从其他格式导入、或使用较高层级的 log / send_columns API 来写 .rrd 文件,而读取数据的唯一途径是 dataframe 或 SQL 查询。这次发布,我们引入了 chunk 级读写 API,让你精确控制数据的确切形状。
这两个变化合起来,意味着 .rrd 已经足够成熟,足以让广泛的团队在其上构建自己的数据层。
面向机器人原生的数据规整的 chunk 处理 API
机器人数据经常是脏的。把来自多个源的数据规整成团队可以分析和训练的东西,复杂度很快就会失控。数据管线的这一部分,往往由拼拼凑凑的 Python 脚本组成——又慢又充满微妙的 bug。
为解决这些问题,我们引入了一套全新的(实验性)chunk 处理 API(英文文档)。它们提供统一的 loader 接口,读取 .rrd、MCAP、Parquet、URDF 等格式,产出 Apache Arrow chunk 流。然后你就可以轻松地在这类流之上定义处理管线。
# Generate one stream per source to merge together
## Mcap with bulk of recorded data
mcap_stream = McapReader("my_file.mcap").stream()
## URDF with static assets
scene_urdf = UrdfTree.from_file_path("scene.urdf", static_transform_entity_path="/tf_static/scene")
## Static offset between two robotic arms that wasn't initially captured
with json_path.open() as f:
    transform = json.load(f)["transform"]
offset_chunk = Chunk.from_columns(
    "/tf_static/robot_offsets",
    columns=rr.Transform3D.columns(**transform)
)
robot_offsets_stream = LazyChunkStream.from_iter([offset_chunk]).stream()

merged_stream = LazyChunkStream.merge(
    mcap_stream,
    scene_urdf,
    offset_chunk,
)
merged_stream.write_rrd()
机器人数据经常以深度嵌套的 struct 形式出现,而数据规整往往意味着对它们的内容做重塑、类型转换和变换。为此我们还发布了 Lenses——一种声明式的数据选择与转换语言,灵感来自 jq。
## Manipulate a standard IMU message
### Extract the x component and cast to float 32
mcap_stream = mcap_stream.lenses(
    MutateLens(
        "Imu:accel",
        Selector(".x").pipe(lambda arr: pc.cast(arr, pa.float32())),
    ),
    content=["/imu"]
)
这些 API 是明确为 coding agent 设计和测试的。我们发现,与通用 Python 相比,agent 用 Rerun chunk 处理 API 能更容易地产出正确且高效的代码。未来,这些 chunk 处理变换除了当前的 SDK 侧执行器之外,还将能在 viewer 中以及通过 Rerun Hub 在云端运行。
对 MCAP、ROS 2 类型和机器人可视化的内置支持扩展
我们认为,让所有机器人数据都容易摄取并在 Rerun 中发挥作用至关重要。同时,大量数据完全不需要定制就能被处理好,而我们在每次发布中都在持续改进这个体验。0.32 带来了更好的性能和更多对 MCAP、常见 ROS 2 类型的开箱支持,以及可用可视化的扩展。更新后的内置支持消息列表见这里。
占用栅格(occupancy grid),即 3D 中的 2D 地图,对移动机器人很重要,也是 Rerun 中被重度请求已久的功能。0.32 因此新增了 GridMap archetype 和可视化器,并内置支持对应的 ROS 2 消息。
新的 GridMap archetype 在 3D 场景中渲染 2D 占用栅格,并内置支持对应的 ROS 2 消息。
另一个常见请求是可视化随时间变化的状态。0.32 带来了新的实验性 State Timeline View。如果你一直在等 Rerun 的这个视图,我们很期待你对这个视图还想看到什么功能的反馈。
新的实验性 State Timeline 视图:类别型状态轨在共享时间轴上被渲染为彩色分段。
带索引的 catalog server:对磁盘上众多 recording 的内容做 SQL 或 dataframe 查询
Rerun SDK 中的 Catalog API 让你能对机器人数据集编写完全通用的 SQL 或 Dataframe 查询。连接 Rerun Hub 时,这个功能已经支持大规模数据集一段时间了;而开源 server 此前只支持完全能放进内存的数据集。0.32 把开源 catalog server 扩展为能索引本地磁盘文件的字节区间,因此现在只凭开源 SDK,你就可以轻松分析本地任意目录下 .rrd 文件格式的机器人 recording。
with rr.server.Server(datasets={"sample_dataset": directory_of_rrds}) as srv:
    client = srv.client()
    df = client.get_dataset("sample_dataset").reader(index="real_time")
    # Count the number of observations where the first gripper joint is greater than some threshold
    df.filter(col("/action/gripper_position:Scalars:scalars")[0] > 0.5).count()
用于快速审查训练与评估数据集的新 UI
0.32 发布了我们的(实验性)数据集审查工具的第一个版本。它能让你同时快速浏览大量 recording,去做异常排查、建立对数据的直觉。你还可以给 recording 打标记,因此也可以当一个简单的标注工具来用。该视图使用普通的 Rerun blueprint 来配置。
实验性数据集审查工具:同时浏览大量 recording,给值得深入看的打标,全部用一个普通 Rerun blueprint 配置。
许多机器人学习团队都要求过这个功能,我们非常期待大家关于如何把它打造成最高效的数据集审查工具的反馈。
支持简单数据集混合与对 .rrd 文件随机寻址的机器人学习 dataloader
我们已启动最受期待的功能之一:Rerun 的 PyTorch dataloader!新的 rerun.experimental.dataloader 模块把 Rerun recording 暴露为可迭代(iterable)或映射(map)风格的 PyTorch 数据集,实时流式传输编码图像、标量和压缩视频(h264/h265/av1)。随机访问、多 worker 预取和 DDP 支持开箱即用。它同时兼容开源 catalog server 和商业产品 Rerun Hub——当你想直接基于对象存储支撑的大规模数据集训练时,它就是为此准备的。
source = DataSource(
    dataset=client.get_dataset("my_robot_data"),
    segments=[
        "ILIAD_50aee79f_2023_07_12_20h_55m_08s",
        "ILIAD_5e938e3b_2023_07_20_10h_40m_10s",
    ],
)

fields = {
    "state": Field("/observation/joint_positions:Scalars:scalars", decode=NumericDecoder()),
    "action": Field("/action/joint_positions:Scalars:scalars", decode=NumericDecoder()),
    "Image.wrist": Field(
        "/camera/wrist:VideoStream:sample",
        decode=VideoFrameDecoder(codec="h264", keyframe_interval=500, fps_estimate=15.0),
    ),
}

ds = RerunIterableDataset(
    source=source,
    index="real_time",
    fields=fields,
    timeline_sampling=FixedRateSampling(rate_hz=15.0),
)
loader = DataLoader(ds, shuffle=False)
能把这个训练 dataloader 发布给社区开始实验,我们无比兴奋。我们打算把它做成想象中最好的机器人学习流式 dataloader,非常期待大家的反馈和诉求。
能够直接在与可视化、分析和变换相同的数据层上训练,对团队真正统一自己的数据层至关重要——这也是他们切实简化系统、加速实验循环的方式。
Rerun Hub 进入 private preview,为规模而生
在过去一年半里,我们一直在与一批优秀的初创公司和实验室一起,低调构建加速机器人学习走向有价值真实应用所需的数据层。我们目前管理着 PB 级的机器人训练数据,已经到了可以为更多团队接入我们的商业产品 Rerun Hub 的阶段——它现已进入 private preview。
Rerun Hub 是一个 catalog 和存储引擎,与开源 Rerun SDK 相连,让机器人学习数据从采集到训练再到部署的工作变得简单。它充当统一的管理和访问层,驱动从摄取、可视化、分析查询、转换到训练的全部核心数据能力。数据可以存放在任何 S3 兼容的对象存储中,Rerun Hub 高效地居中调解从对象存储到 Rerun SDK 的直接选择性流式传输——用于你的训练任务或大规模并行后处理任务。这个集中化的 Hub 还通过让"用代码或在 viewer 中交互式地构造可分享的数据链接"变得容易,简化了协作和自动化审查。
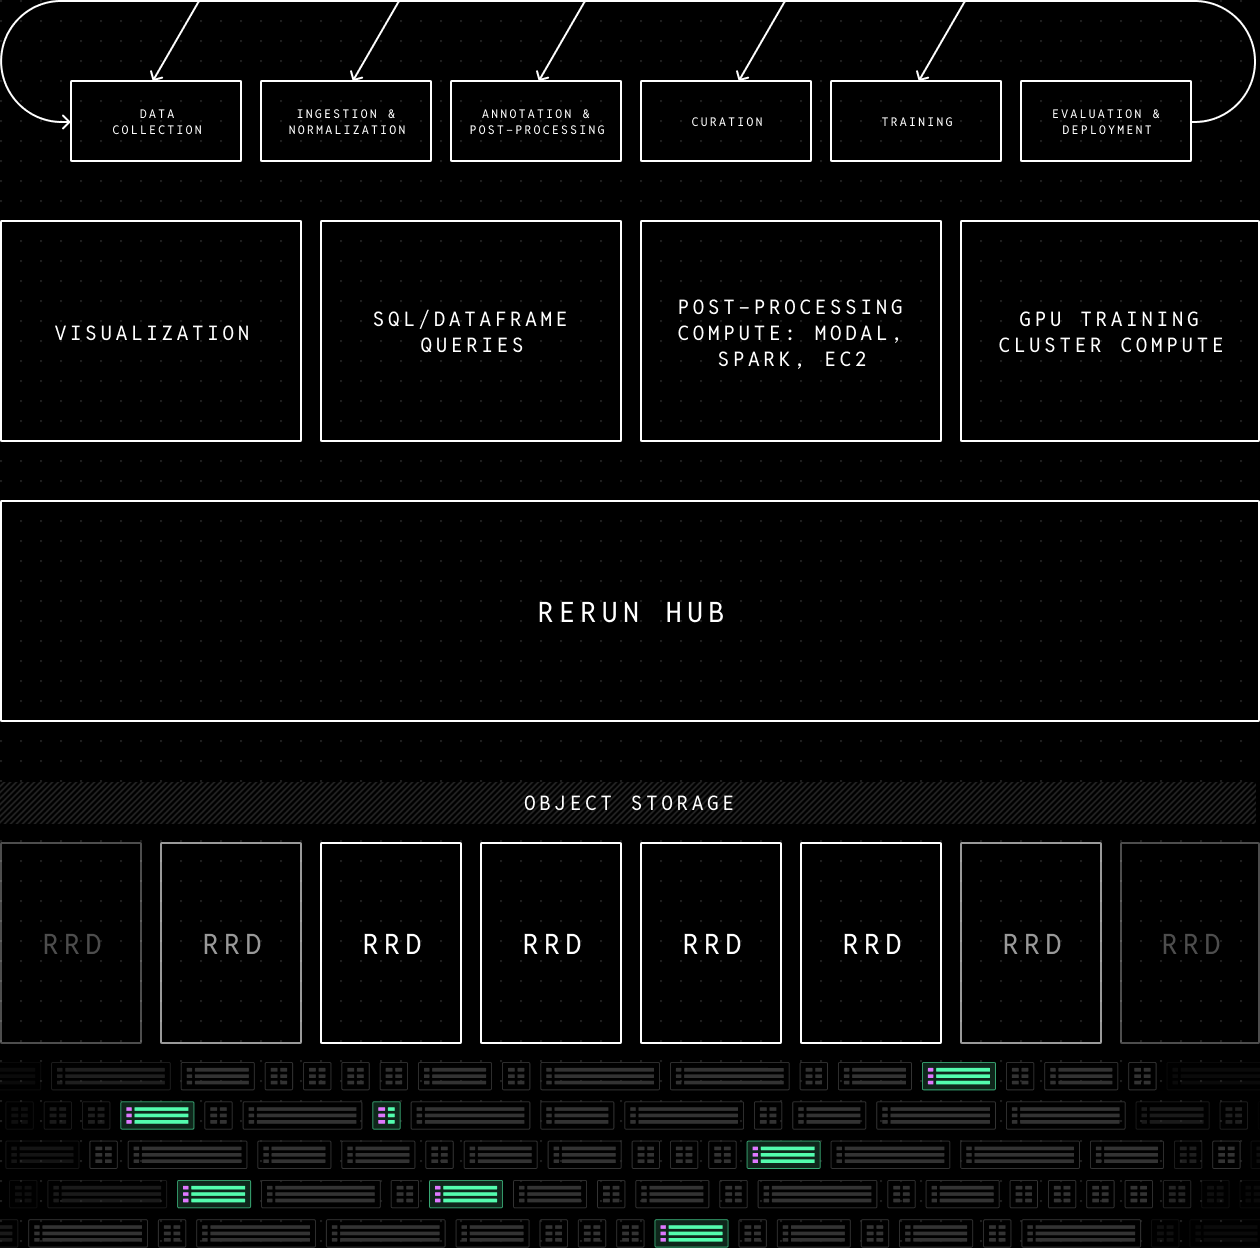
一张图看懂 Rerun Hub:机器人学习生命周期的每个环节、每种计算能力,都对着同一个 catalog 和访问层工作,其背后是对象存储中的 .rrd 文件。
如果你正在构建智能机器人,并有兴趣升级自己的数据层以更快迭代,欢迎联系。对于已经用复杂现有系统达到一定规模的团队,Rerun 可以很容易地逐步采纳;我们还可以提供驻场工程师(forward deployed engineers),帮你在不把核心人力从其他要务上调走的情况下完成升级。
原文:A new data layer for robot learning · 作者:Nikolaus West · 发布于 Rerun Blog,2026-05-13
相关文章:The Data Layer Tax for Robot Learning · Rerun 0.32 release notes