Ray:面向新兴 AI 应用的分布式框架
译文说明
原文:Ray: A Distributed Framework for Emerging AI Applications,作者 Philipp Moritz*、Robert Nishihara*、Stephanie Wang、Alexey Tumanov、Richard Liaw、Eric Liang、Melih Elibol、Zongheng Yang、William Paul、Michael I. Jordan、Ion Stoica(加州大学伯克利分校,*同等贡献),发表于 OSDI 2018。译文仅供参考学习,论文与图像素材版权归原作者所有。
摘要
下一代 AI 应用将持续与环境交互,并从这些交互中学习。这类应用在性能和灵活性两方面都提出了新的、苛刻的系统需求。本文分析这些需求,并给出 Ray——一个用以应对这些需求的分布式系统。Ray 实现了一套统一接口,既能表达任务并行(task-parallel)计算,也能表达基于 Actor 的计算,并由单一的动态执行引擎支撑。为满足性能需求,Ray 采用分布式调度器和一个分布式、容错的状态存储来管理系统的控制状态。实验中,我们展示了 Ray 扩展到每秒 180 万任务以上,并在若干有挑战性的强化学习应用上取得了优于现有专用系统的性能。
1 引言
过去二十年里,许多组织一直在收集——并试图利用——持续增长的数据。这催生了大量用于分布式数据分析的框架,包括批处理系统 [20, 64, 28]、流处理系统 [15, 39, 31] 和图处理系统 [34, 35, 24]。这些框架的成功使组织能够把分析大数据集作为其商业或科学战略的核心部分,并开启了"大数据"时代。
近来,数据密集型应用的范围已经扩展到更复杂的人工智能(AI)与机器学习(ML)技术 [30]。其范式情形是监督学习:数据点带有标签,而把数据点映射到标签的主力技术是深度神经网络。这些深度网络的复杂性又催生了一批专注于深度神经网络训练与预测使用的框架。这些框架通常利用专用硬件(如 GPU 和 TPU),目标是在批处理场景下缩短训练时间,例子包括 TensorFlow [7]、MXNet [18] 和 PyTorch [46]。
然而,AI 的前景远不止经典的监督学习。新兴的 AI 应用必须越来越多地在动态环境中运行、对环境变化做出反应,并采取一系列行动以达成长期目标 [8, 43]。它们不仅必须利用已收集的数据,还必须探索可能行动的空间。这些更广泛的需求自然地被纳入强化学习(RL)的范式之中。RL 研究如何基于延迟且有限的反馈,在不确定的环境中持续运行 [56]。基于 RL 的系统已经取得了令人瞩目的成果,例如 Google 的 AlphaGo 击败人类世界冠军 [54],并且开始进入对话系统、无人机 [42] 和机器人操作 [25, 60] 等领域。
RL 应用的核心目标是学习一个策略(policy)——从环境状态到行动选择的映射——使其随时间推移获得有效表现,例如赢下一局棋或驾驶一架无人机。在大规模应用中找到有效的策略需要三种主要能力。第一,RL 方法通常依赖仿真(simulation)来评估策略。仿真使得探索许多不同的行动序列选择、并了解这些选择的长期后果成为可能。第二,与其监督学习的"同门"一样,RL 算法需要执行分布式训练,以基于仿真或与物理环境交互所产生的数据来改进策略。第三,策略旨在为控制问题提供解决方案,因此有必要在交互式闭环与开环控制场景中**服务(serve)**策略。
这些特性驱动了新的系统需求:面向 RL 的系统必须支持细粒度计算(例如与现实世界交互时在毫秒级内给出动作,以及执行海量仿真),必须在时间上(一次仿真可能耗时毫秒到小时)和资源使用上(训练用 GPU、仿真用 CPU)都支持异构,还必须支持动态执行,因为仿真或环境交互的结果会改变未来的计算。因此,我们需要一个动态计算框架,以毫秒级延迟每秒处理数百万个异构任务。
为大数据负载或监督学习负载而开发的现有框架无法满足 RL 的这些新需求。MapReduce [20]、Apache Spark [64] 和 Dryad [28] 这样的批量同步并行系统不支持细粒度仿真或策略服务。CIEL [40] 和 Dask [48] 这样的任务并行系统几乎不支持分布式训练和服务。Naiad [39] 和 Storm [31] 等流处理系统同样如此。TensorFlow [7] 和 MXNet [18] 等分布式深度学习框架并不能自然地支持仿真与服务。最后,TensorFlow Serving [6] 和 Clipper [19] 等模型服务系统则既不支持训练也不支持仿真。
原则上,可以把多个现有系统拼接起来构建端到端方案(例如用 Horovod [53] 做分布式训练、Clipper [19] 做服务、CIEL [40] 做仿真),但实践中由于这些组件在应用内部被紧耦合在一起,这种做法是行不通的。结果就是,今天的研究者和工程师为专门的 RL 应用构建一次性的系统 [58, 41, 54, 44, 49, 5]。这种做法把调度、容错、数据搬运这类标准系统挑战实质上推给了每个应用,给分布式应用的开发背上了沉重的系统工程负担。
本文提出 Ray:一个通用集群计算框架,为 RL 应用提供仿真、训练与服务能力。这些负载的需求从轻量无状态计算(如仿真)到长时运行的有状态计算(如训练)不等。为满足这些需求,Ray 实现了一套统一接口,既能表达任务并行计算,也能表达基于 Actor 的计算。**任务(task)**使 Ray 能够高效、动态地为仿真做负载均衡,处理大规模输入和状态空间(如图像、视频),并从故障中恢复。相比之下,Actor使 Ray 能够高效支持有状态计算(如模型训练),并向客户端暴露共享的可变状态(例如参数服务器)。Ray 在一个高度可扩展、容错的单一动态执行引擎之上实现 Actor 与任务这两种抽象。
为满足性能需求,Ray 把现有框架 [64, 28, 40] 中通常集中式的两个组件分布化了:(1) 任务调度器;(2) 维护计算血缘和数据对象目录的元数据存储。这使 Ray 能以毫秒级延迟每秒调度数百万个任务。此外,Ray 为任务和 Actor 提供基于血缘的容错,为元数据存储提供基于复制的容错。
尽管 Ray 在 RL 应用的语境下支持服务、训练和仿真,这并不意味着它应被看作其他语境下为这些负载提供方案的系统替代品。特别地,Ray 并不打算替代 Clipper [19] 和 TensorFlow Serving [6] 这类服务系统,因为后者处理模型部署中更广泛的挑战,包括模型管理、测试和模型组合。同样,尽管 Ray 很灵活,它也不是 Spark [64] 这类通用数据并行框架的替代品,因为它目前缺少这些框架提供的丰富功能和 API(如慢任务缓解、查询优化)。
本文的贡献如下:
- 我们设计并构建了第一个统一训练、仿真与服务的分布式框架——这三者是新兴 RL 应用的必要组件。
- 为支撑这些负载,我们在动态任务执行引擎之上统一了 Actor 与任务并行抽象。
- 为实现可扩展性与容错性,我们提出一条系统设计原则:控制状态存储于分片元数据存储中,系统其他所有组件均为无状态。
- 为实现可扩展性,我们提出了一种自底向上的分布式调度策略。
2 动机与需求
我们先考察 RL 系统的基本组件,并充实 Ray 的关键需求。如图 1 所示,在 RL 场景中,**智能体(agent)与环境(environment)反复交互。智能体的目标是学习一个能最大化奖励(reward)的策略。策略是从环境状态到动作(action)**选择的映射。环境、智能体、状态、动作和奖励的精确定义取决于具体应用。
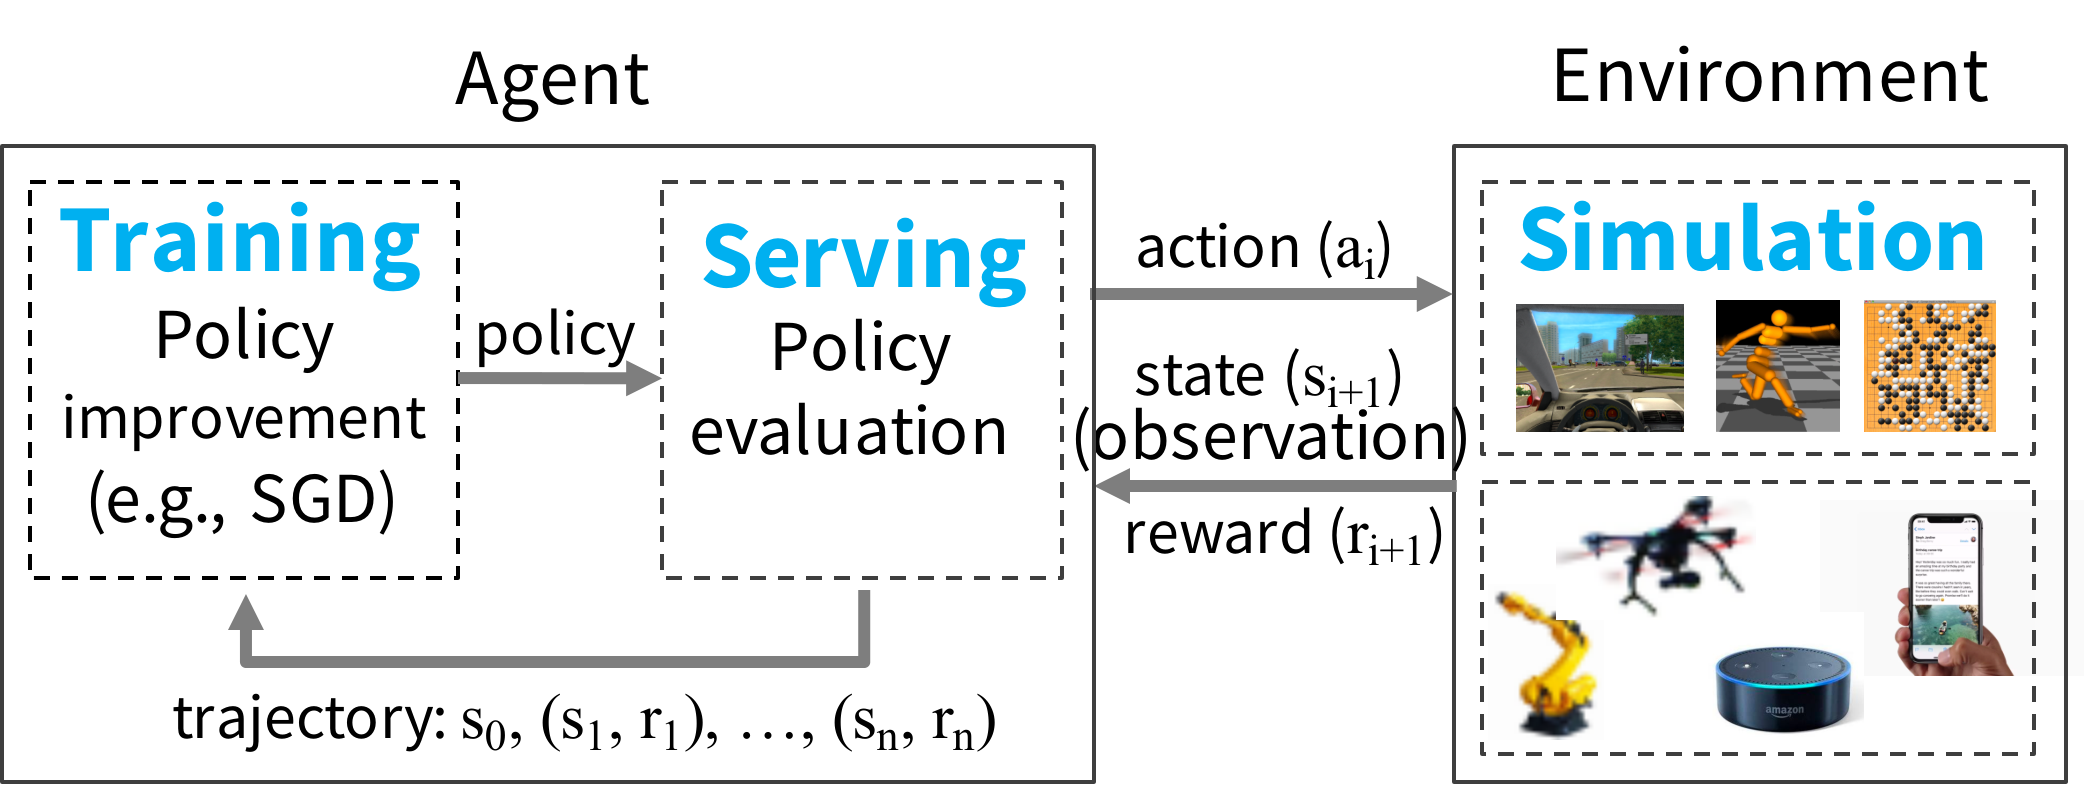
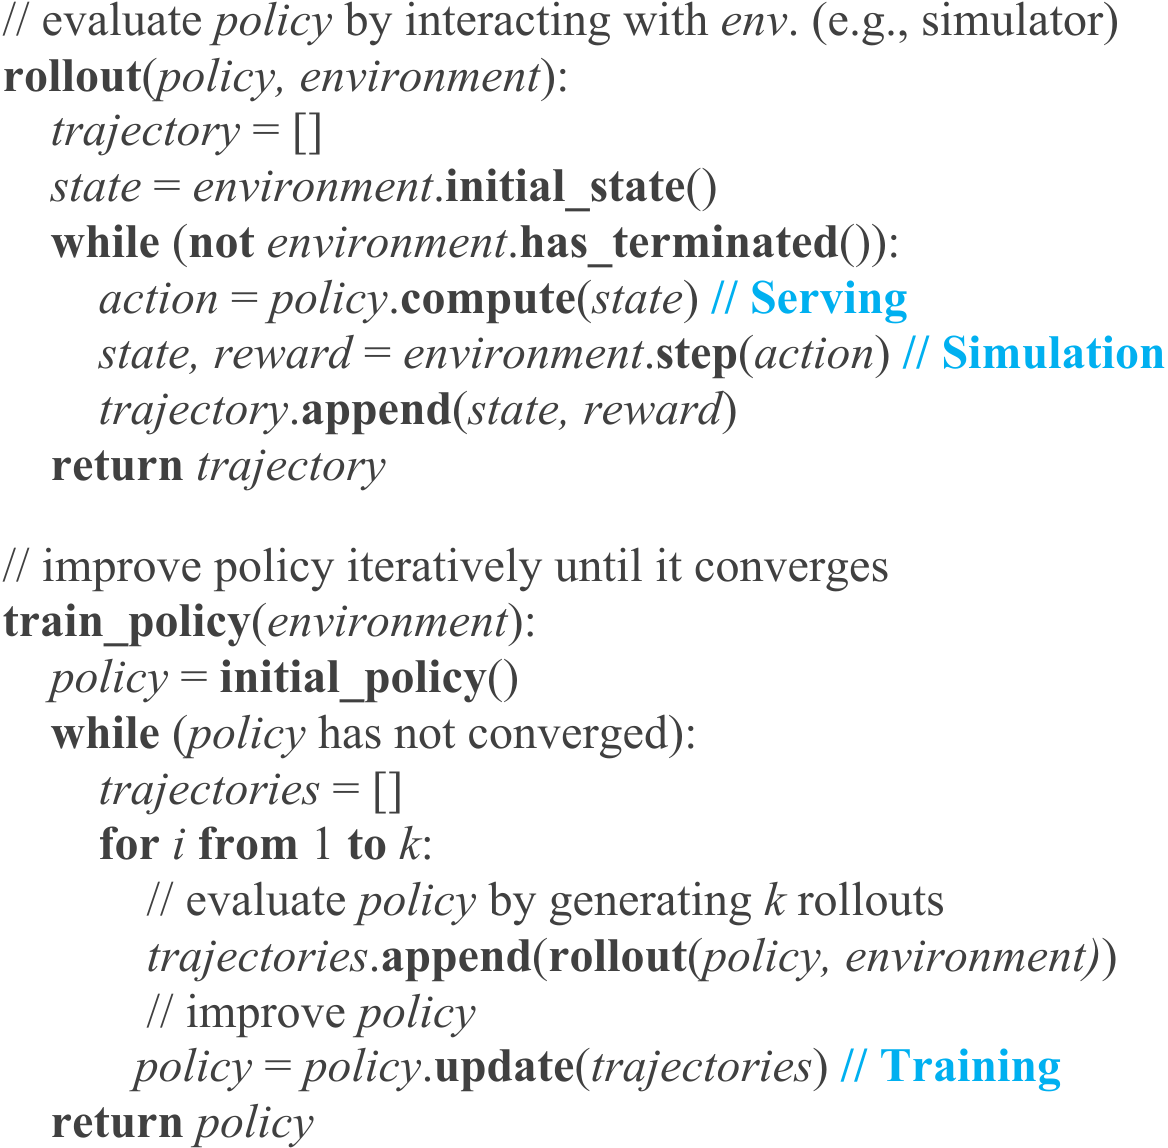
要学习一个策略,智能体通常采用两步过程:(1) 策略评估(policy evaluation);(2) 策略改进(policy improvement)。为评估策略,智能体与环境(例如环境的仿真器)交互以生成轨迹(trajectory)——轨迹由当前策略产生的一系列(状态,奖励)元组构成。然后,智能体利用这些轨迹改进策略,即沿最大化奖励的梯度方向更新策略。图 2 给出了智能体学习策略所用的伪代码示例。这段伪代码通过调用 rollout(environment, policy) 生成轨迹来评估策略;train_policy() 继而通过 policy.update(trajectories) 利用这些轨迹改进当前策略。这一过程不断重复直至策略收敛。
因此,面向 RL 应用的框架必须对训练、服务和仿真(图 1)提供高效支持。下面我们简要描述这些负载。
训练通常涉及运行随机梯度下降(SGD)来更新策略,通常以分布式方式进行。分布式 SGD 一般依赖 allreduce 聚合步骤或参数服务器 [32]。
服务用训练好的策略,基于环境的当前状态给出动作。服务系统的目标是最小化延迟、最大化每秒决策数。为扩展规模,负载通常在多个服务策略的节点间做均衡。
最后,现有大多数 RL 应用使用仿真来评估策略——当前的 RL 算法样本效率还不够高,无法只依靠与物理世界交互得到的数据。这些仿真的复杂度差异很大:可能只需几毫秒(例如模拟 chess 棋局中的一步),也可能长达数分钟(例如为自动驾驶汽车仿真一个逼真环境)。
与监督学习不同——监督学习的训练和服务可以由不同系统分别处理——在 RL 中,这三类负载紧耦合在单个应用之中,彼此之间有苛刻的延迟要求。目前还没有框架支持这种负载耦合。理论上可以把多个专用框架拼接起来提供整体能力,但实践中,系统之间的数据搬运和延迟在 RL 场景下是让人无法接受的。结果就是,研究者和工程师一直在构建自己的一次性系统。
这种状况呼唤为 RL 开发新的分布式框架,能够高效支持训练、服务和仿真。具体而言,这样的框架应满足以下需求:
细粒度、异构的计算。 一次计算的持续时间可能从毫秒级(例如执行一个动作)到小时级(例如训练一个复杂策略)不等。此外,训练往往需要异构硬件(CPU、GPU 或 TPU)。
灵活的计算模型。 RL 应用同时需要无状态和有状态计算。无状态计算可以在系统中任意节点上执行,这使得负载均衡以及在必要时把计算移动到数据所在位置都很容易。因此无状态计算非常适合细粒度仿真和数据处理(例如从图像或视频中提取特征)。相比之下,有状态计算非常适合实现参数服务器、在 GPU 上的数据执行重复计算,或运行不暴露其状态的第三方仿真器。
动态执行。 RL 应用的若干组件需要动态执行:计算完成的先后顺序并不总能事先知道(例如各次仿真完成的顺序),而且一次计算的结果可能决定未来的计算(例如一次仿真的结果将决定是否需要执行更多仿真)。
最后还有两点说明。第一,为在大集群上实现高利用率,这样的框架必须能每秒处理数百万任务(假设单核任务耗时 5ms、集群有 200 台 32 核节点,则每秒可运行 (1s/5ms) × 32 × 200 = 128 万任务)。第二,这样的框架并不旨在从零实现深度神经网络或复杂仿真器;相反,它应当能与现有仿真器 [13, 11, 59] 和深度学习框架 [7, 18, 46, 29] 无缝集成。
3 编程模型与计算模型
Ray 实现了一种动态任务图计算模型,即把应用建模为一张在执行过程中不断演化的、由相互依赖的任务组成的图。在这个模型之上,Ray 同时提供 Actor 和任务并行两种编程抽象。这种统一使 Ray 有别于相关系统:CIEL 只提供任务并行抽象,而 Orleans [14] 或 Akka [1] 主要提供 Actor 抽象。
3.1 编程模型
任务(Task)。 任务表示在无状态工作进程上执行一个远程函数。调用远程函数时,会立即返回一个代表该任务结果的 future。future 可以用 ray.get() 取回,也可以作为参数传入其他远程函数,而无需等待其完成。这使得用户既能表达并行性,又能刻画数据依赖。表 1 列出了 Ray 的 API。
表 1:Ray API
| 名称 | 描述 |
|---|---|
futures = f.remote(args) | 远程执行函数 f。f.remote() 可以接受对象或 future 作为输入,并返回一个或多个 future。非阻塞。 |
objects = ray.get(futures) | 返回与一个或多个 future 关联的值。阻塞。 |
ready_futures = ray.wait(futures, k, timeout) | 一旦有 k 个任务完成或超时到期,即返回对应任务已完成的那些 future。 |
actor = Class.remote(args) | 把类 Class 实例化为一个远程 Actor,并返回它的句柄。在远程 Actor 上调用方法,返回一个或多个 future。两者都非阻塞。 |
futures = actor.method.remote(args) | 同上:在远程 Actor 上调用方法,返回一个或多个 future。 |
远程函数作用在不可变对象上,并且应当是无状态、无副作用的:其输出完全由输入决定。这意味着幂等性,从而简化了容错——故障时可通过函数重执行来实现。
Actor。 Actor 表示有状态计算。每个 Actor 暴露可以远程调用的方法,这些方法被串行执行。方法执行与任务类似——在远程执行并返回 future——区别在于它在有状态的工作进程上执行。Actor 的句柄可以传递给其他 Actor 或任务,使它们能够调用该 Actor 的方法。
表 2:任务与 Actor 的权衡
| 任务(无状态) | Actor(有状态) |
|---|---|
| 细粒度负载均衡 | 粗粒度负载均衡 |
| 支持对象局部性 | 局部性支持差 |
| 小更新的开销高 | 小更新的开销低 |
| 高效的故障处理 | 检查点带来的开销 |
表 2 总结了任务和 Actor 的性质。任务通过在任务粒度上做负载感知的调度来实现细粒度负载均衡;支持输入数据局部性——每个任务都可以被调度到存储其输入的节点上;并且恢复开销低——无需检查点并恢复中间状态。相比之下,Actor 提供更高效的小粒度更新,因为这些更新作用于内部状态而非外部状态(后者通常需要序列化和反序列化)。例如,Actor 可用于实现参数服务器 [32] 和基于 GPU 的迭代计算(如训练)。此外,Actor 还可用于包装第三方仿真器以及其他难以序列化的不透明句柄。
为满足异构性与灵活性需求(第 2 节),我们从三个方面扩展了 API。第一,为处理持续时间异构的并发任务,我们引入 ray.wait():它等待最先可用的 k 个结果,而不是像 ray.get() 那样等待全部结果。第二,为处理资源异构的任务,我们允许开发者指定资源需求,以便 Ray 调度器高效管理资源。第三,为提高灵活性,我们支持嵌套远程函数——远程函数可以调用其他远程函数。这对实现高可扩展性(第 4 节)也至关重要,因为它使多个进程能以分布式方式调用远程函数。
3.2 计算模型
Ray 采用动态任务图计算模型 [21]:远程函数和 Actor 方法的执行都由系统在输入就绪时自动触发。本节描述计算图(图 4)如何从用户程序(图 3)构建出来。该程序用表 1 的 API 实现了图 2 的伪代码。
@ray.remote
def create_policy():
  # Initialize the policy randomly.
  return policy

@ray.remote(num_gpus=1)
class Simulator(object):
  def __init__(self):
    # Initialize the environment.
    self.env = Environment()
  def rollout(self, policy, num_steps):
    observations = []
    observation = self.env.current_state()
    for _ in range(num_steps):
      action = policy(observation)
      observation = self.env.step(action)
      observations.append(observation)
    return observations

@ray.remote(num_gpus=2)
def update_policy(policy, *rollouts):
  # Update the policy.
  return policy

@ray.remote
def train_policy():
  # Create a policy.
  policy_id = create_policy.remote()
  # Create 10 actors.
  simulators = [Simulator.remote() for _ in range(10)]
  # Do 100 steps of training.
  for _ in range(100):
    # Perform one rollout on each actor.
    rollout_ids = [s.rollout.remote(policy_id)
                   for s in simulators]
    # Update the policy with the rollouts.
    policy_id = update_policy.remote(policy_id, *rollout_ids)
  return ray.get(policy_id)
图 3:用 Python 实现图 2 示例的 Ray 代码。注意 @ray.remote 表示远程函数和 Actor。远程函数与 Actor 方法的调用都返回 future,这些 future 可以传给后续的远程函数或 Actor 方法以编码任务依赖。每个 Actor 都有一个在其所有方法间共享的环境对象 self.env。
先不考虑 Actor,计算图中有两类节点:数据对象和远程函数调用(即任务)。边也有两类:数据边和控制边。数据边刻画数据对象与任务之间的依赖。更精确地说,若数据对象 D 是任务 T 的输出,我们就加一条从 T 到 D 的数据边;类似地,若 D 是 T 的输入,就加一条从 D 到 T 的数据边。控制边刻画由嵌套远程函数(第 3.1 节)带来的计算依赖:若任务 T1 调用了任务 T2,就加一条从 T1 到 T2 的控制边。
Actor 方法调用也表示为计算图中的节点。它们与任务完全相同,只有一个关键区别。为刻画同一 Actor 上相继方法调用之间的状态依赖,我们加入第三类边:有状态边(stateful edge)。若方法 Mj 在同一 Actor 上紧随方法 Mi 被调用,就加一条从 Mi 到 Mj 的有状态边。于是,同一 Actor 对象上的所有方法调用构成一条由有状态边连接的链(图 4)。这条链刻画了这些方法被调用的顺序。
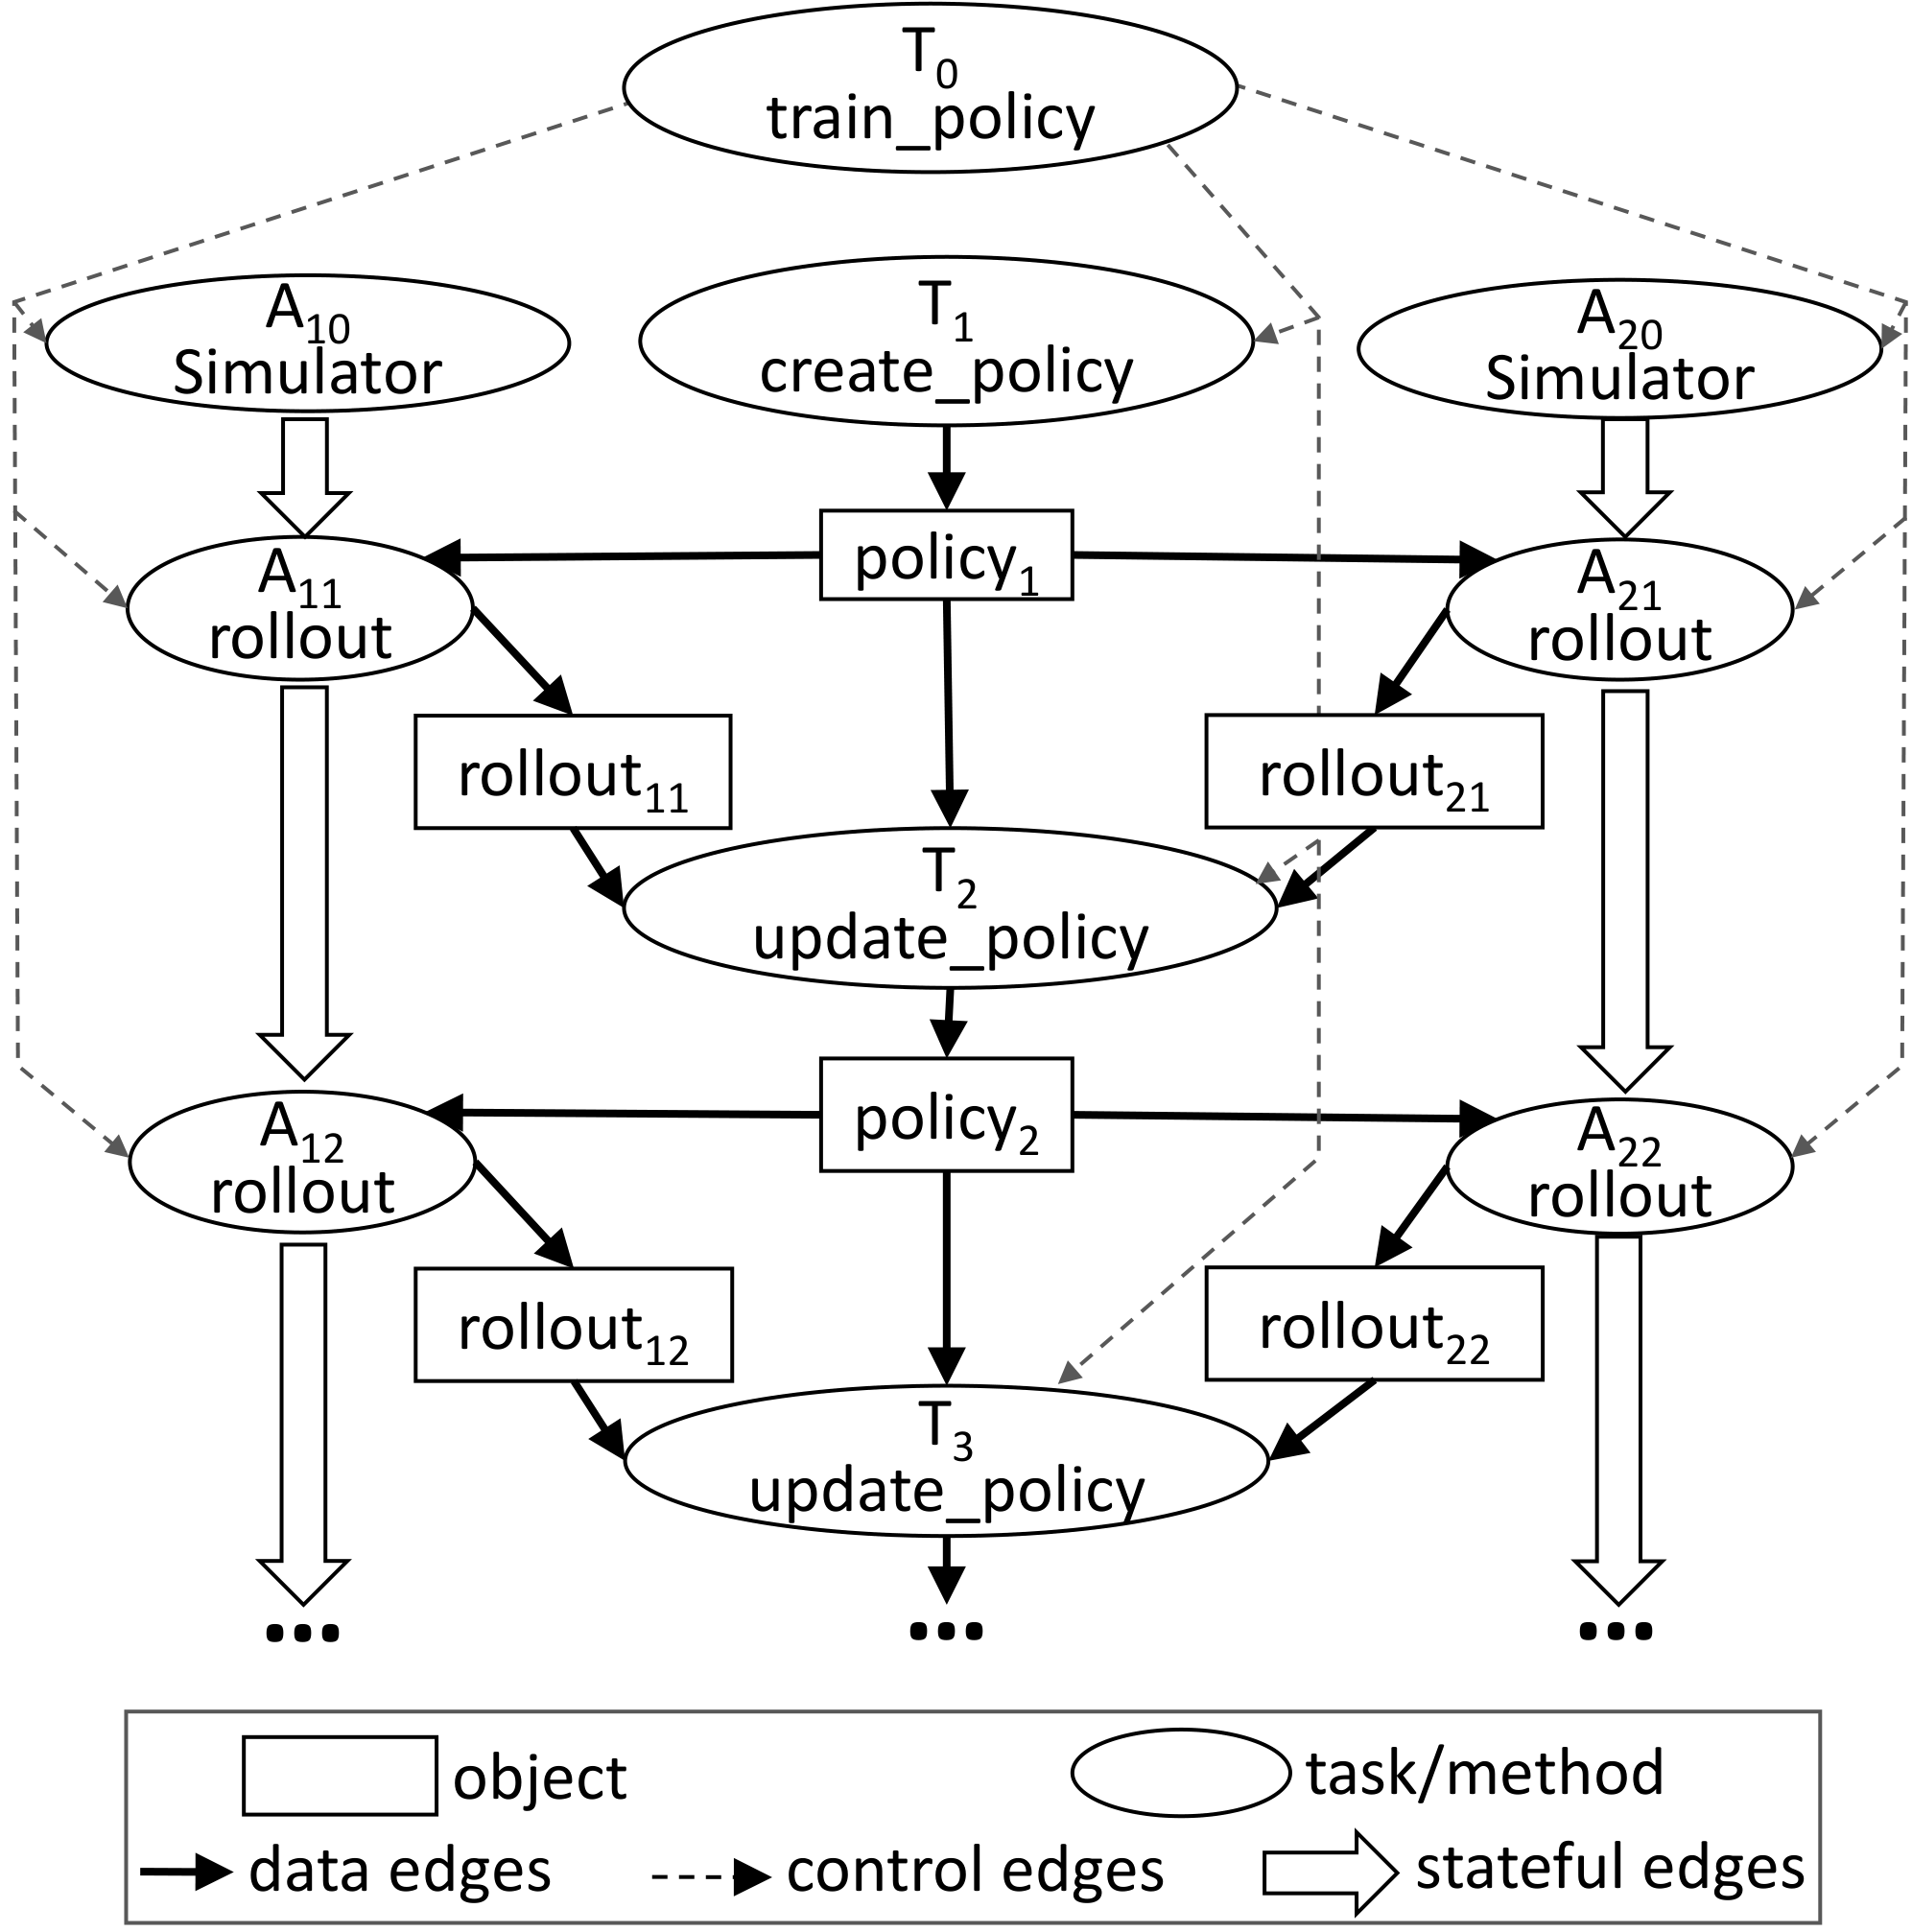
有状态边使我们能把 Actor 嵌入原本无状态的任务图,因为它们刻画了共享 Actor 内部状态的相继方法调用之间隐式的数据依赖。有状态边还使我们能够维护血缘(lineage)。与其他数据流系统 [64] 一样,我们跟踪数据血缘以支持重建。通过在血缘图中显式包含有状态边,无论是远程函数还是 Actor 方法产生的丢失数据,都可以轻易重建(第 4.2.3 节)。
4 架构
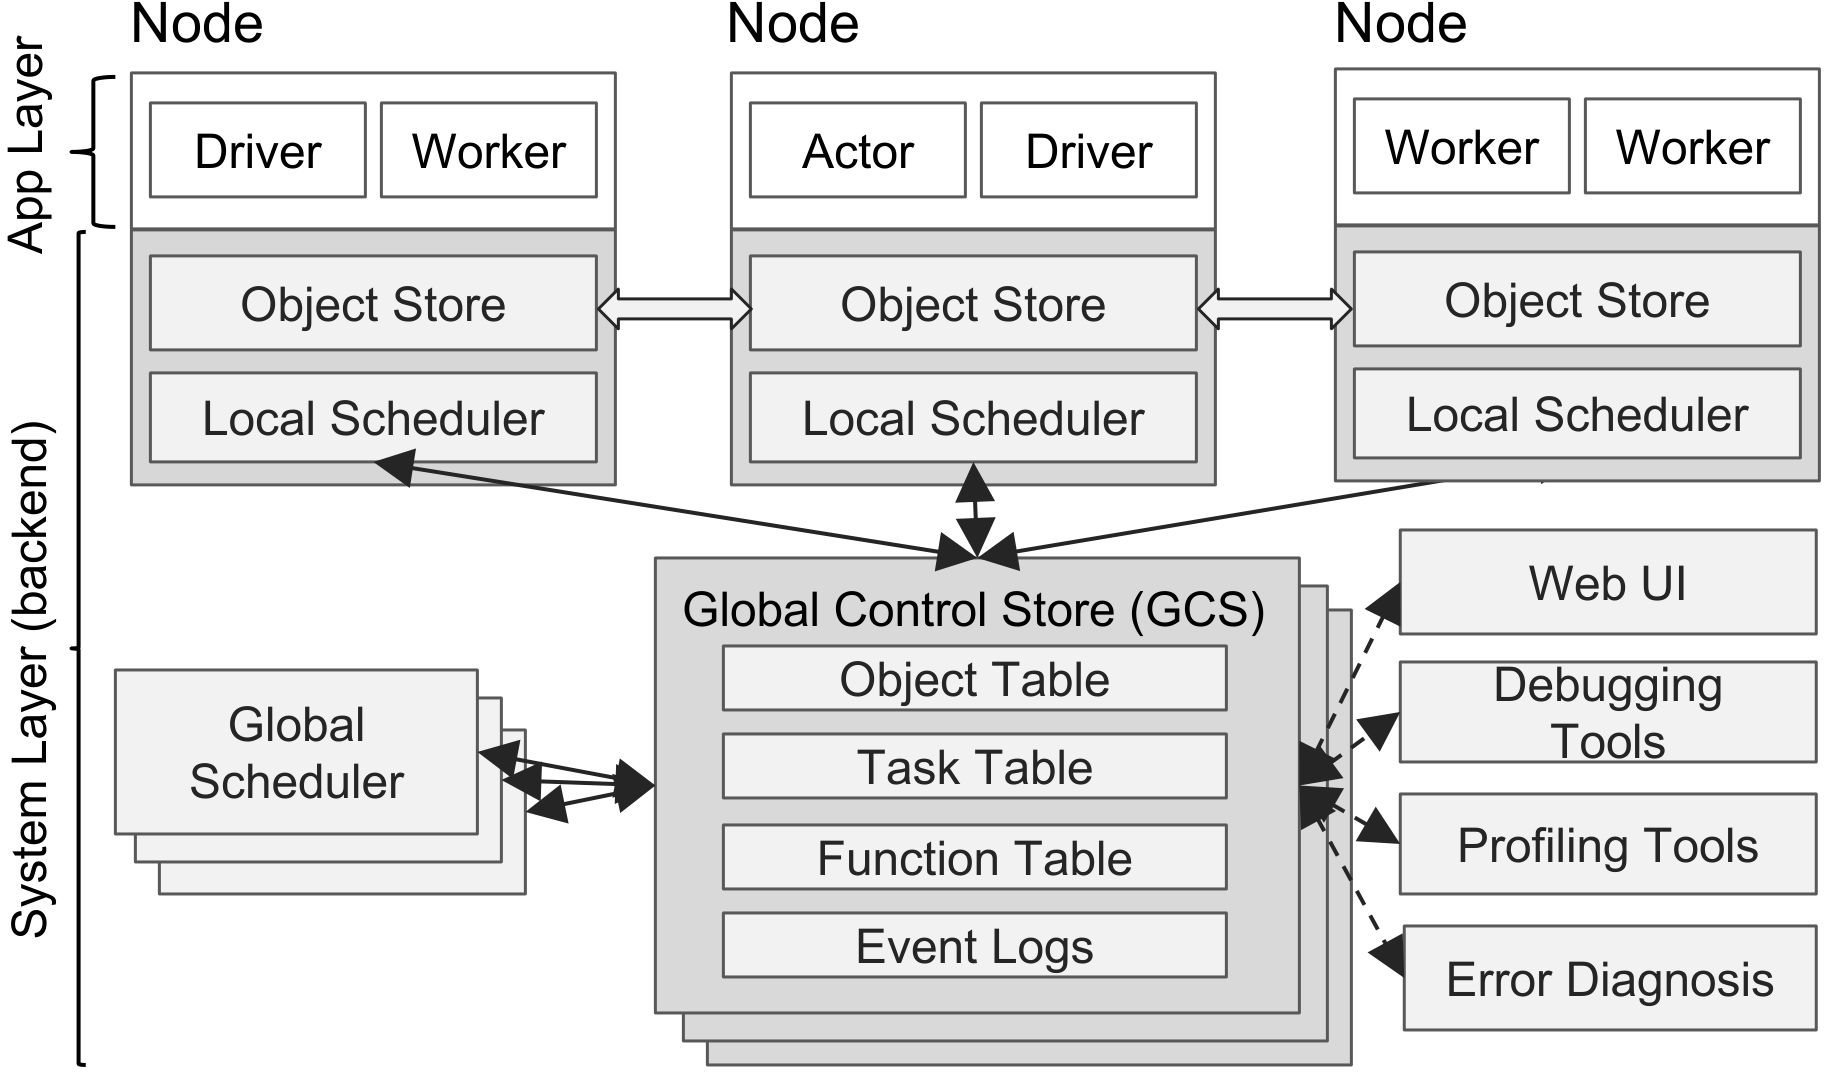
Ray 的架构由两部分组成:(1) 实现 API 的应用层;(2) 提供高可扩展性与容错的系统层。
4.1 应用层
应用层由三类进程组成:
- Driver(驱动程序):执行用户程序的进程。
- Worker(工作进程):执行由 Driver 或其他 Worker 调用的任务(远程函数)的无状态进程。Worker 由系统自动启动并由系统层分配任务。当一个远程函数被声明时,它会自动发布到所有 Worker。Worker 串行执行任务,任务之间不维护本地状态。
- Actor:有状态进程,被调用时只执行它暴露的方法。与 Worker 不同,Actor 由 Worker 或 Driver 显式实例化。与 Worker 一样,Actor 也串行执行方法,区别在于每个方法都依赖于前一个方法执行所产生的状态。
4.2 系统层
系统层由三个主要组件构成:全局控制存储、分布式调度器和分布式对象存储。所有组件均可水平扩展且容错。
4.2.1 全局控制存储(GCS)
全局控制存储(Global Control Store,GCS)维护系统的全部控制状态,这是我们设计中独有的特性。GCS 的核心是一个带发布-订阅功能的键值存储。我们用分片实现扩展,用逐分片的链式复制(chain replication)[61] 提供容错。GCS 及其设计的首要原因,是在一个每秒能动态产生数百万任务的系统中同时保持容错与低延迟。
节点故障时的容错需要一个维护血缘信息的方案。现有的基于血缘的方案 [64, 63, 40, 28] 面向粗粒度并行,因此可以用单个节点(如 master、driver)存储血缘而不影响性能。然而,对于仿真这样细粒度、动态的负载,这种设计无法扩展。因此,我们把持久化的血缘存储与其他系统组件解耦,使各方能够独立扩展。
保持低延迟则需要最小化任务调度(选择在哪里执行)与随后的任务分发(从其他节点取回远程输入)两方面的开销。许多现有数据流系统 [64, 40, 48] 把两者耦合在一起:把对象的位置和大小存储在中央调度器中——当调度器不是瓶颈时这是一种自然的设计。然而,Ray 所针对的规模和粒度要求把集中式调度器移出关键路径。让调度器参与每一次对象传输,对 allreduce 这类对分布式训练至关重要的原语来说是代价高到无法接受的——它们既通信密集又对延迟敏感。因此,我们把对象元数据存储在 GCS 而非调度器中,把任务分发与任务调度完全解耦。
总而言之,GCS 极大简化了 Ray 的整体设计,因为它使系统中每个组件都可以是无状态的。这不仅简化了容错支持(故障时组件只需重启并从 GCS 读取血缘),也使分布式对象存储和调度器易于独立扩展——所有组件都通过 GCS 共享所需状态。另一个附带好处是便于开发调试、性能分析和可视化工具。
4.2.2 自底向上分布式调度器
如第 2 节所述,Ray 需要动态调度每秒数百万个、最短仅几毫秒的任务。我们所知的集群调度器没有一个能满足这些要求。Spark [64]、CIEL [40] 和 Dryad [28] 等大多数集群计算框架实现的是集中式调度器,可以提供局部性,但延迟在几十毫秒量级。work stealing [12]、Sparrow [45] 和 Canary [47] 等分布式调度器可以达到很高的规模,但它们要么不考虑数据局部性 [12],要么假设任务属于相互独立的作业 [45],要么假设计算图已知 [47]。
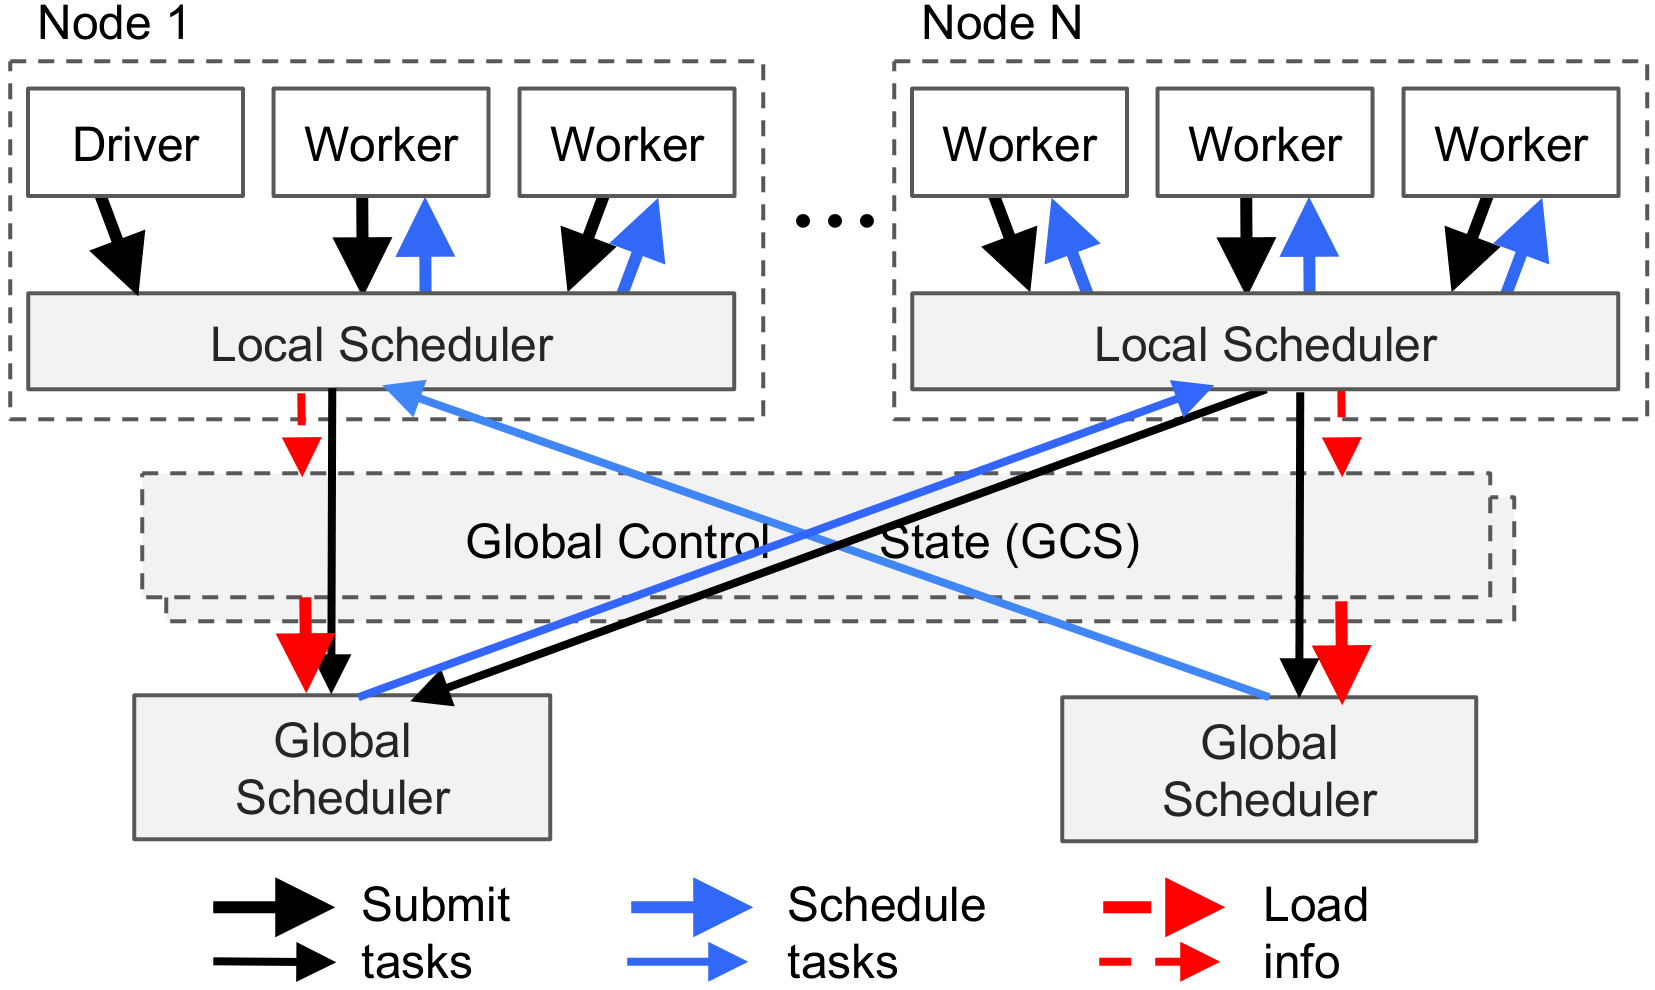
为满足上述需求,我们设计了一个由全局调度器和每节点本地调度器组成的两级层次调度器。为避免全局调度器过载,在某个节点上创建的任务首先被提交给该节点的本地调度器。本地调度器会在本节点调度任务,除非该节点过载(即本地任务队列超过预设阈值),或无法满足任务的需求(例如缺少 GPU)。如果本地调度器决定不在本地调度某任务,就将其转发给全局调度器。由于这种调度器首先尝试在本地(即调度层次结构的叶子节点)调度任务,我们称其为自底向上调度器。
全局调度器在做出调度决策时会考虑每个节点的负载和任务的约束。更确切地说,全局调度器先找出拥有任务所请求类型足够资源的节点集合,再从中选择预计等待时间最低的节点。在给定节点上,该时间为以下两项之和:(i) 任务在该节点排队时间的估计(任务队列长度乘以平均任务执行时间);(ii) 任务远程输入的预计传输时间(远程输入总大小除以平均带宽)。全局调度器通过心跳获取每个节点的队列长度与节点资源可用量,从 GCS 获取任务输入的位置和大小。此外,全局调度器用简单的指数平均法计算平均任务执行时间和平均传输带宽。如果全局调度器成为瓶颈,我们可以实例化更多副本,它们都通过 GCS 共享相同信息。这使我们的调度器架构具有很高的可扩展性。
4.2.3 内存分布式对象存储
为最小化任务延迟,我们实现了一个内存分布式存储系统,用于存储每个任务(即无状态计算)的输入和输出。在每个节点上,我们通过共享内存实现对象存储,同一节点上运行的任务之间可以零拷贝共享数据。数据格式我们采用 Apache Arrow [2]。
如果任务的输入不在本地,输入会在执行前被复制到本地对象存储。任务也会把输出写入本地对象存储。复制消除了热数据对象可能带来的瓶颈,并最小化任务执行时间——任务只从本地内存读写数据。这提高了计算密集型负载的吞吐,而许多 AI 应用正是这种 profile。为保持低延迟,对象完全驻留内存,并按 LRU 策略在需要时逐出到磁盘。
与 Spark [64]、Dryad [28] 等现有集群计算框架一样,对象存储仅限于不可变数据。这消除了对复杂一致性协议的需要(对象不会被更新),也简化了容错支持。发生节点故障时,Ray 通过血缘重执行来恢复任何需要的对象。GCS 中存储的血缘在初始执行期间同时跟踪无状态任务和有状态 Actor;我们用前者来重建对象存储中的对象。
为简单起见,我们的对象存储不支持分布式对象,即每个对象都必须能放在单个节点上。大矩阵或树这类分布式对象,可以在应用层用 future 集合来实现。
4.2.4 实现
Ray 是一个活跃的开源项目(github.com/ray-project/ray),在加州大学伯克利分校开发。Ray 与 Python 环境完全集成,只需运行 pip install ray 即可轻松安装。实现约 4 万行代码(LoC),其中 72% 为 C++(系统层),28% 为 Python(应用层)。GCS 每个分片使用一个 Redis [50] 键值存储,且全部为单键操作。GCS 表按对象和任务 ID 分片以扩展规模,每个分片都做链式复制 [61] 以容错。本地与全局调度器均实现为事件驱动的单线程进程。在内部,本地调度器维护本地对象元数据、等待输入的任务、以及准备好分发给 Worker 的任务的缓存状态。为了在对象存储之间传输大对象,我们把对象条带化到多条 TCP 连接上传输。
4.3 端到端示例
图 7 用一个简单例子说明了 Ray 的端到端工作方式:把两个对象 a 和 b(可以是标量或矩阵)相加并返回结果 c。远程函数 add() 在初始化时自动注册到 GCS 并分发到系统中每个 Worker(图 7a 的步骤 0)。
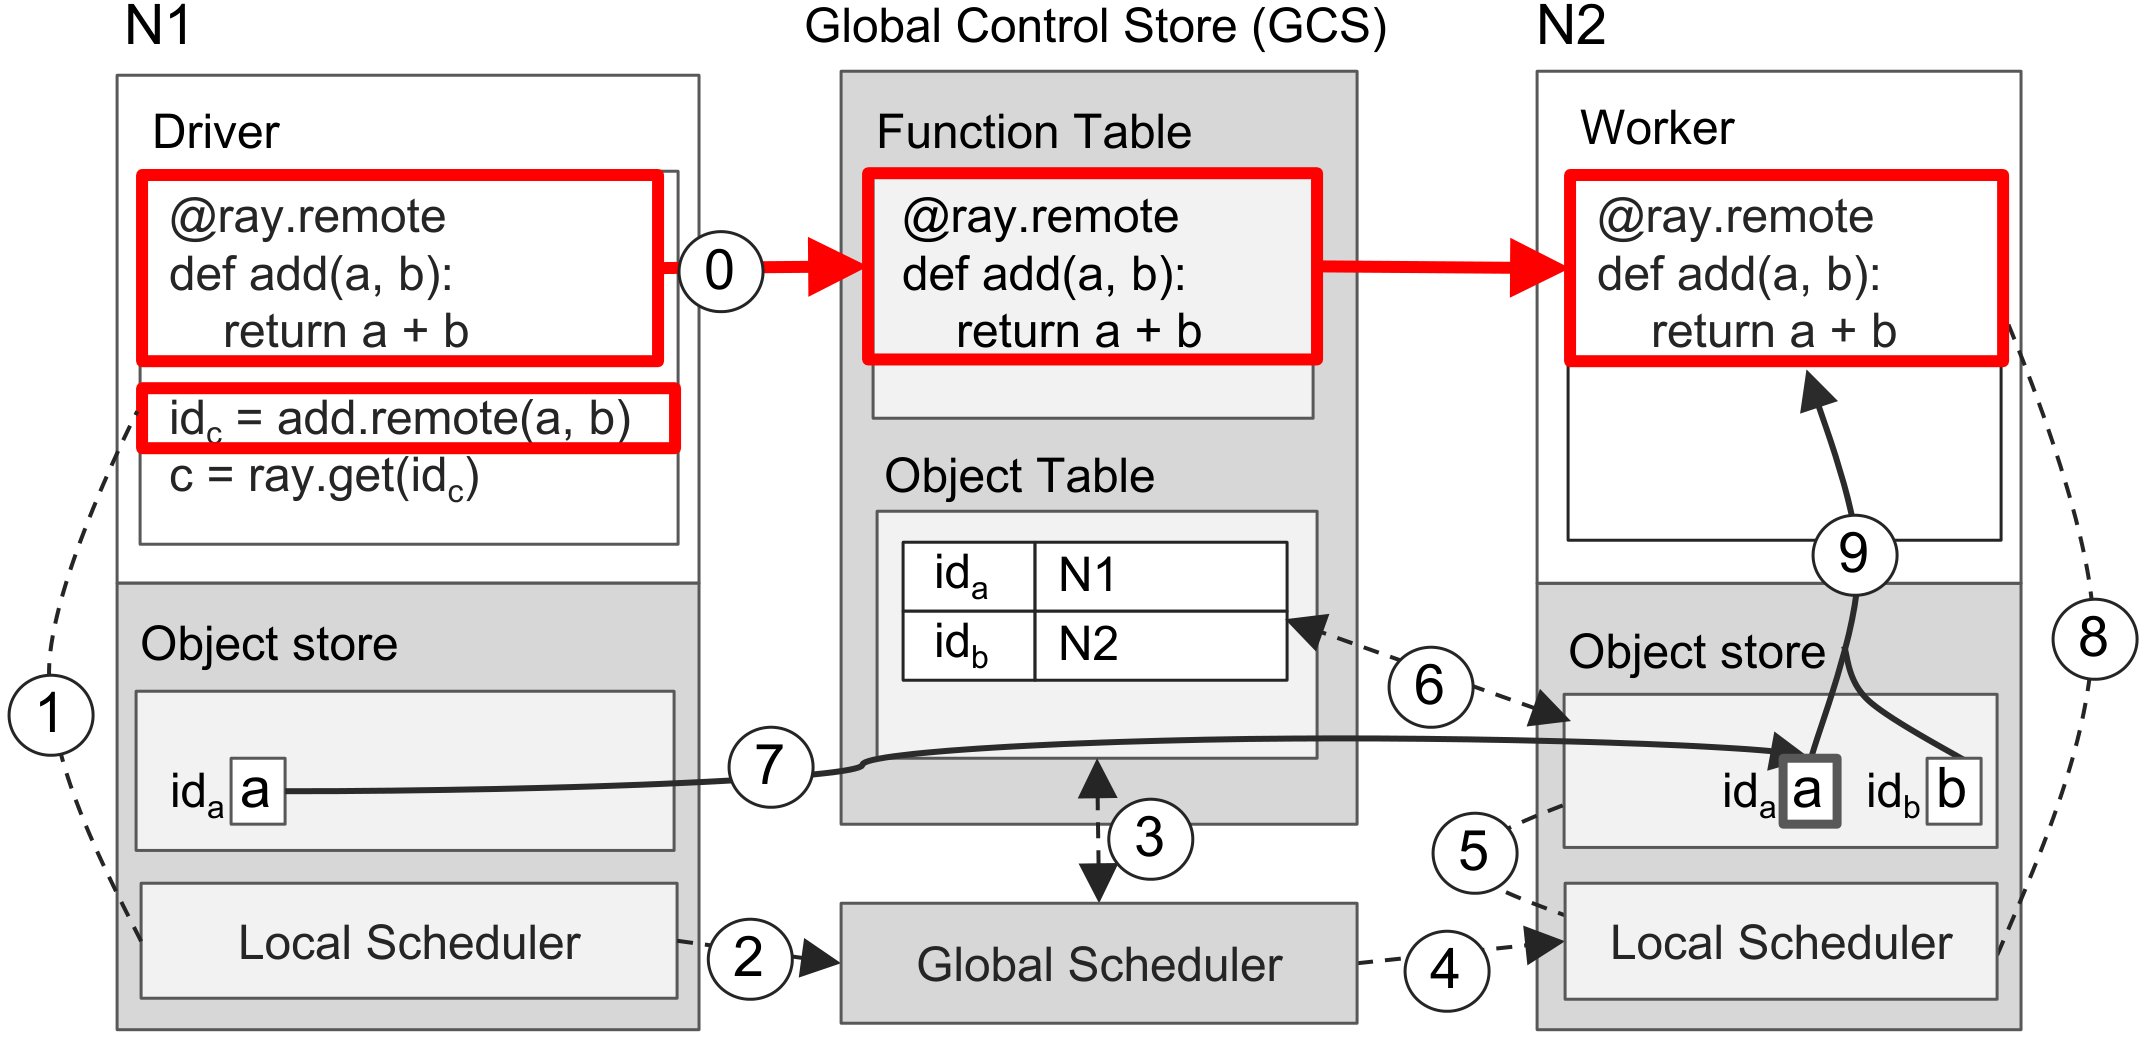
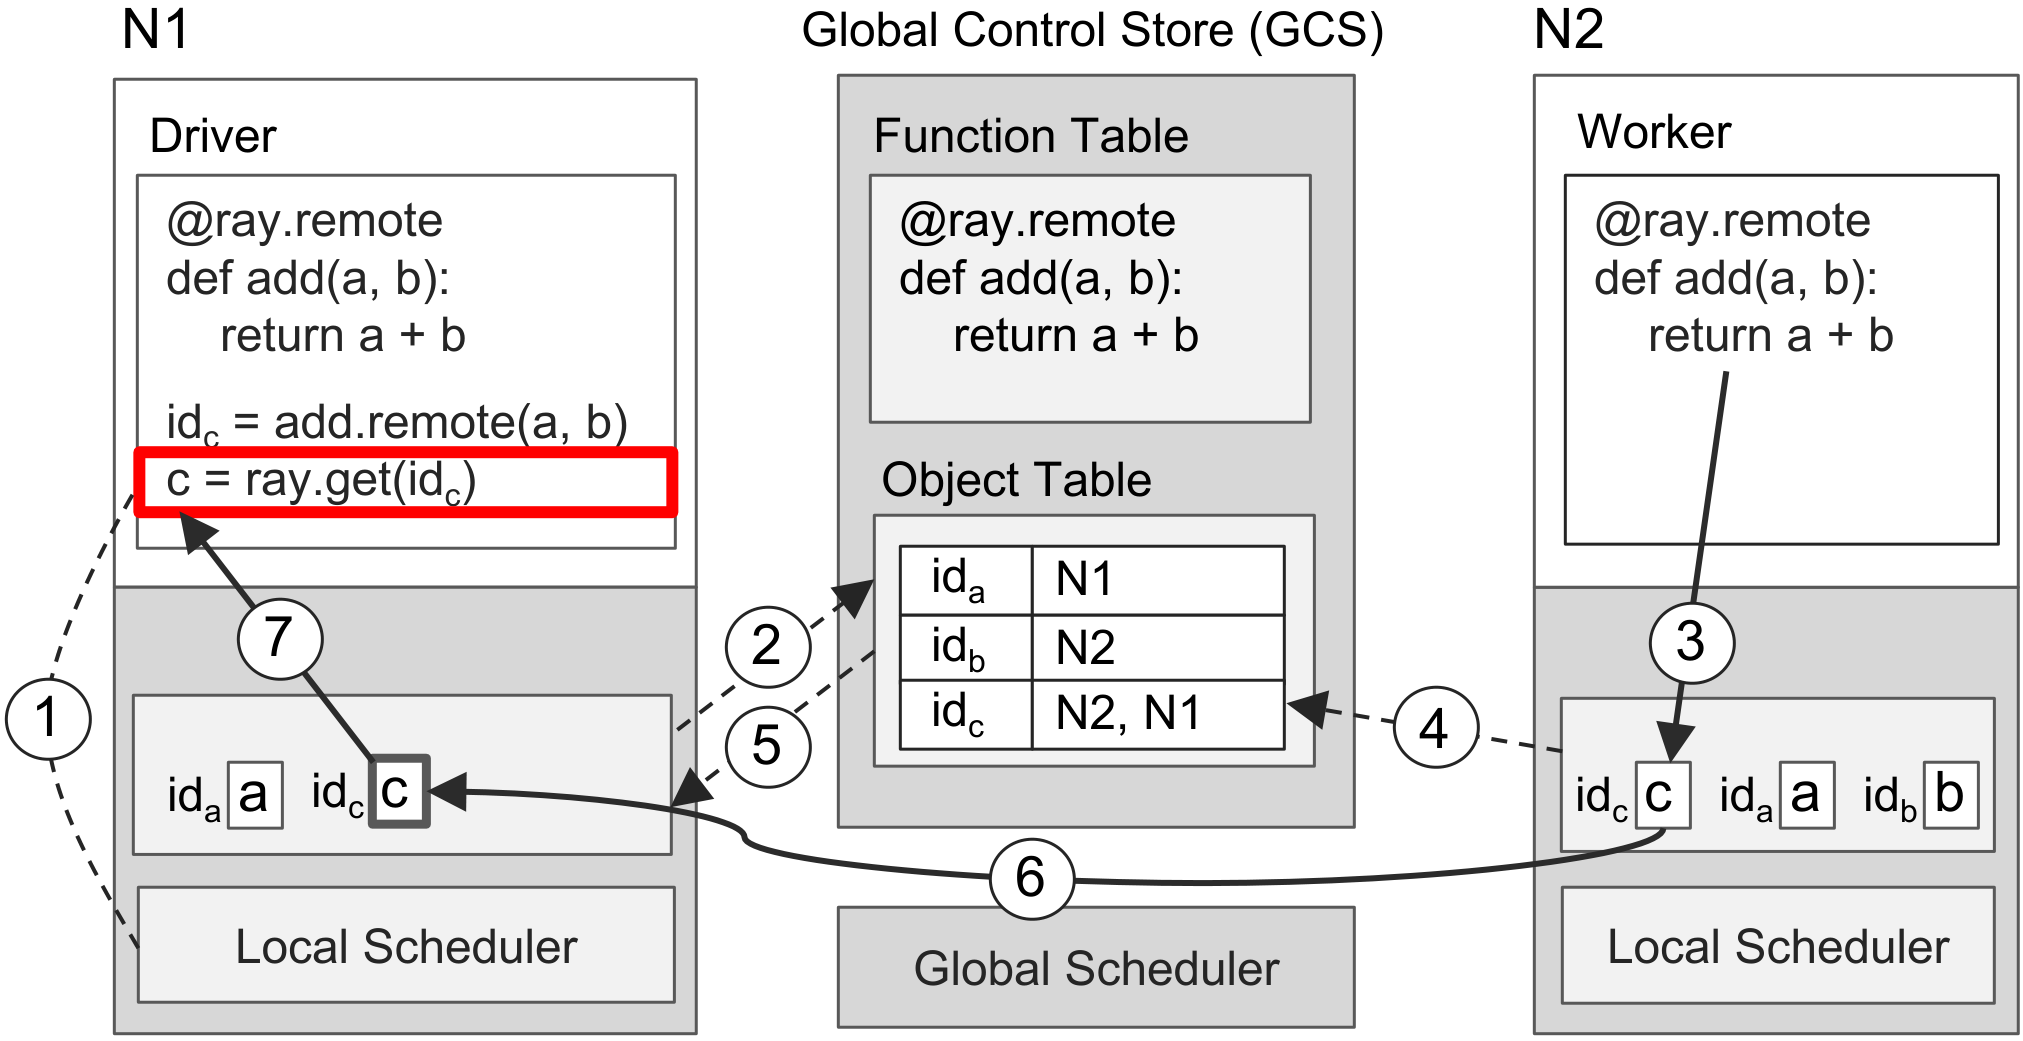
图 7:一个把 a 和 b 相加并返回 c 的端到端示例。实线是数据面操作,虚线是控制面操作。(a) 函数 add() 由节点 1(N1)注册到 GCS,在 N1 上调用,在 N2 上执行。(b) N1 用 ray.get() 获取 add() 的结果。c 在 Object Table 中的条目在第 4 步创建,并在 c 被复制到 N1 后的第 6 步更新。
图 7a 展示了 Driver 调用 add.remote(a, b)(a 和 b 分别存储在节点 N1、N2 上)触发的逐步操作。Driver 把 add(a, b) 提交给本地调度器(步骤 1),本地调度器将其转发给全局调度器(步骤 2)(注意 N1 也可以决定把任务调度在本地执行)。接着,全局调度器在 GCS 中查找 add(a, b) 各参数的位置(步骤 3),并决定把任务调度到存储参数 b 的节点 N2(步骤 4)。N2 的本地调度器检查本地对象存储是否包含 add(a, b) 的参数(步骤 5)。由于本地存储没有对象 a,它在 GCS 中查找 a 的位置(步骤 6)。得知 a 存储在 N1 后,N2 的对象存储将其复制到本地(步骤 7)。至此 add() 的所有参数都已存储在本地,本地调度器在本地 Worker 上调用 add()(步骤 8),Worker 通过共享内存访问参数(步骤 9)。
图 7b 展示了 N1 上 ray.get() 的执行和 N2 上 add() 的执行分别触发的逐步操作。调用 ray.get(id_c) 时,Driver 用 add() 返回的 future id_c 在本地对象存储中查找值 c(步骤 1)。由于本地对象存储没有 c,它在 GCS 中查找其位置。此时 c 还没有条目,因为它尚未被创建。于是 N1 的对象存储向 Object Table 注册一个回调,待 c 的条目创建时被触发(步骤 2)。与此同时,在 N2 上 add() 完成执行,把结果 c 存入本地对象存储(步骤 3),并随之把 c 的条目加入 GCS(步骤 4)。于是 GCS 向 N1 的对象存储触发带有 c 条目的回调(步骤 5)。接下来,N1 从 N2 复制 c(步骤 6),并把 c 返回给 ray.get()(步骤 7),任务至此完成。
这个例子涉及大量 RPC,但在很多情况下这一数量要小得多:大多数任务都在本地调度,且全局与本地调度器都会缓存 GCS 的应答。
5 评估
在评估中,我们研究以下问题:
- Ray 在多大程度上满足第 2 节所列的延迟、可扩展性和容错需求?(第 5.1 节)
- 用 Ray 的 API 编写的分布式原语(如 allreduce)会引入多少开销?(第 5.1 节)
- 在 RL 负载的语境下,Ray 与面向训练、服务和仿真的专用系统相比如何?(第 5.2 节)
- 与定制系统相比,Ray 为 RL 应用带来什么优势?(第 5.3 节)
所有实验都在 Amazon Web Services 上运行。除非另有说明,我们使用 m4.16xlarge CPU 实例和 p3.16xlarge GPU 实例。
5.1 微基准
局部性感知的任务放置。 细粒度负载均衡和局部性感知的放置是 Ray 中任务的主要优势。Actor 一旦被放置,就无法把计算移动到大型远程对象上,而任务可以。在图 8a 中,不感知数据局部性的任务放置(Actor 方法就是如此)在 10–100MB 的输入数据规模下会遭受 1–2 个数量级的延迟增长。Ray 通过共享对象存储统一了任务与 Actor,使开发者可以用任务对仿真 Actor 产生的输出执行昂贵的后处理等操作。
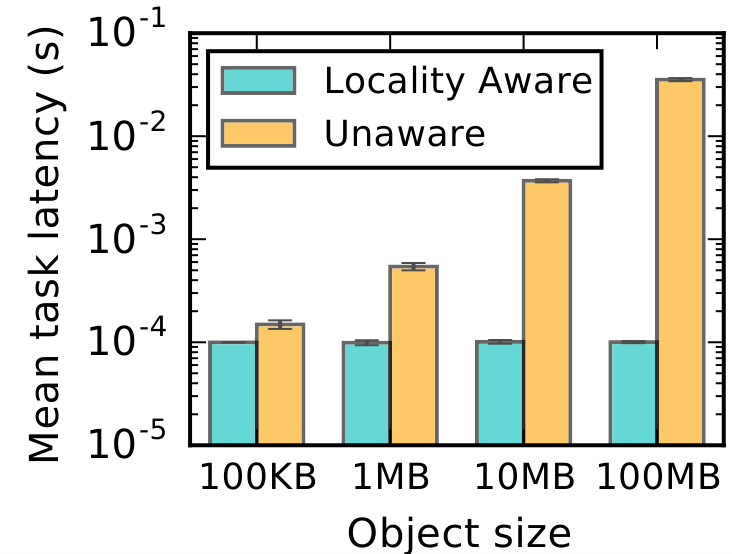
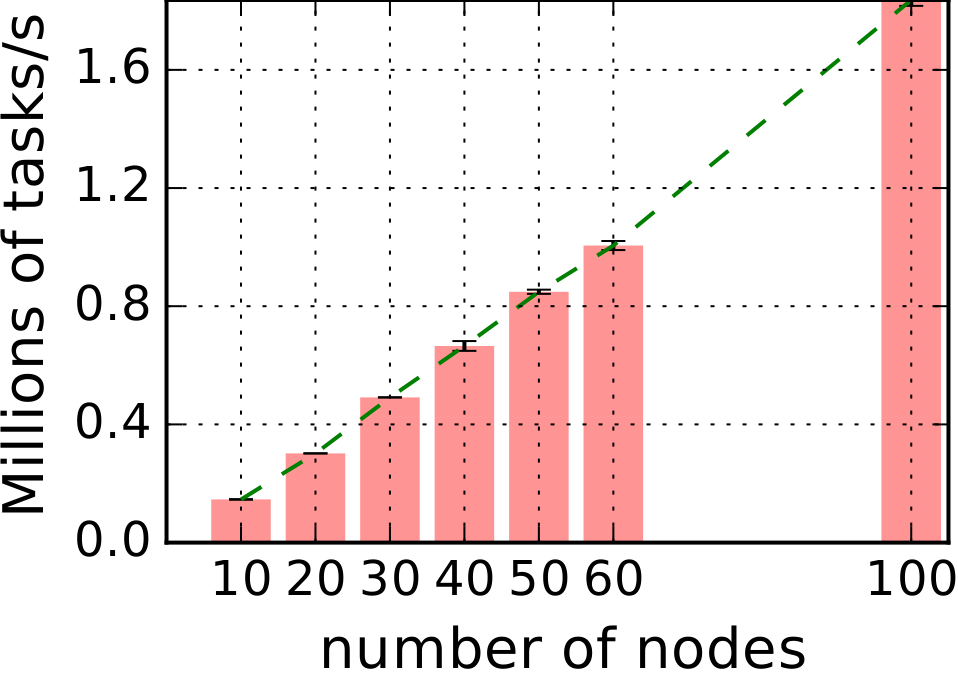
图 8:(a) 任务利用局部性感知的放置。1000 个带有随机对象依赖的任务被调度到两个节点之一。采用局部性感知策略时,任务延迟与任务输入的大小无关,而不是增长 1–2 个数量级。(b) 利用 GCS 与自底向上分布式调度器实现近线性扩展。Ray 在 60 个节点时达到每秒 100 万任务的吞吐。x ∈ {70, 80, 90} 因成本原因省略。
端到端可扩展性。 GCS 和自底向上分布式调度器的关键优势之一,是能把系统水平扩展以支撑细粒度任务的高吞吐,同时保持容错与低延迟的任务调度。在图 8b 中,我们在一个由空任务组成的、易并行的工作负载上评估这一能力,x 轴为逐渐增大的集群规模。我们观察到任务吞吐的增长接近完美的线性。Ray 在 60 个节点时超过每秒 100 万任务的吞吐,并在 100 个节点时继续线性扩展到每秒 180 万任务以上。最右侧的数据点显示 Ray 能在不到一分钟(54 秒)内处理 1 亿个任务,且波动极小。如预期的那样,增加任务时长会使吞吐按平均任务时长等比例下降,但整体可扩展性仍保持线性。尽管许多真实负载由于对象依赖和应用并行度的固有上限,可扩展性可能更有限,但这证明了我们的整体架构在高负载下的可扩展性。
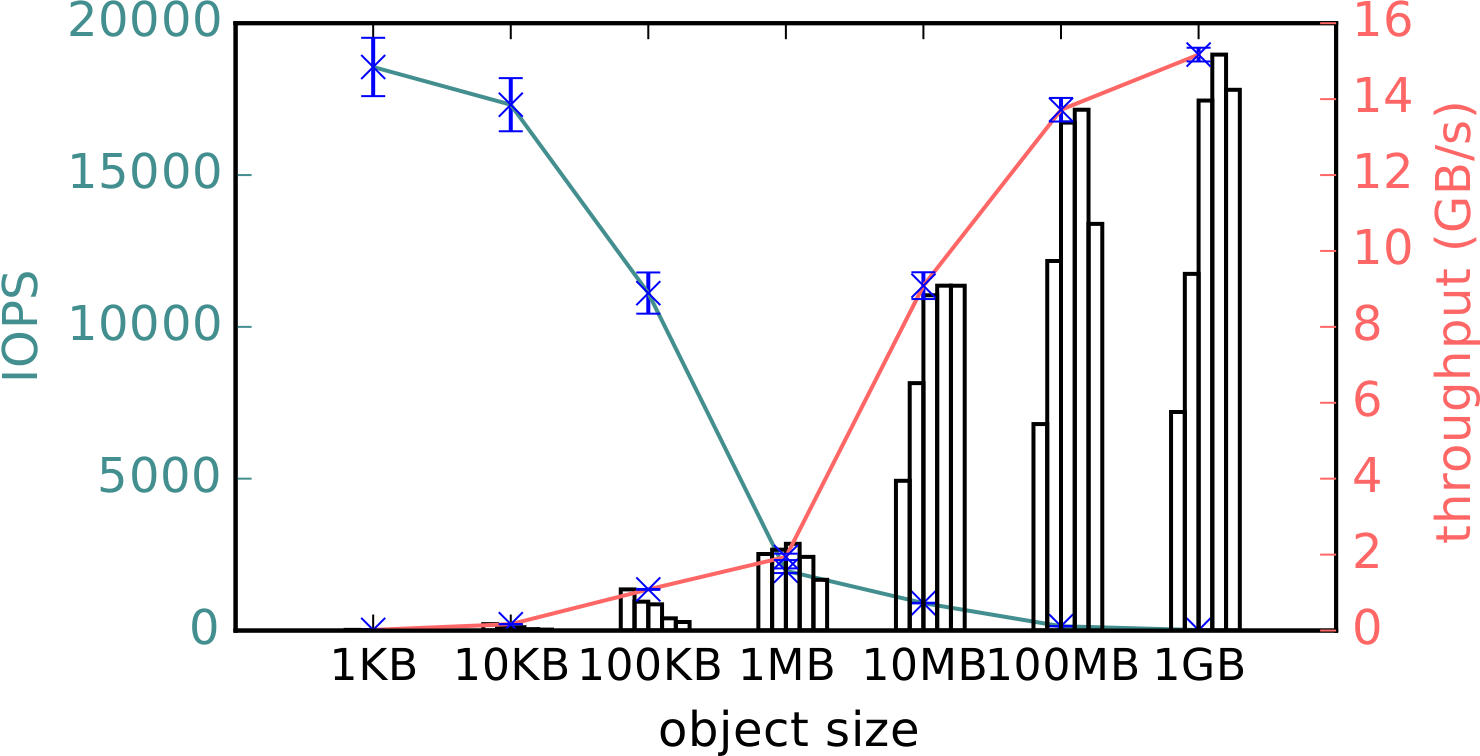
对象存储性能。 为评估对象存储的性能(第 4.2.3 节),我们跟踪两个指标:IOPS(对应小对象)和写吞吐(对应大对象)。在图 9 中,单客户端的写吞吐随对象增大超过 15GB/s。对于更大的对象,对象创建时间以内存拷贝(memcpy)为主。对于更小的对象,主要开销在客户端与对象存储之间的序列化和进程间通信。
GCS 容错。 为在提供强一致性与容错的同时保持低延迟,我们在 Redis 之上构建了一个轻量级链式复制 [61] 层。图 10a 模拟向 GCS 记录 Ray 任务和从 GCS 读取任务,其中键 25 字节、值 512 字节。客户端尽可能快地发送请求,同一时刻最多只有一个在途请求。故障由客户端(收到显式错误或尽管重试仍超时)或链上任意服务器(收到显式错误)报告给链主节点。总体上,重配置造成的客户端可观测最大延迟低于 30ms(这其中包含故障检测与恢复延迟)。
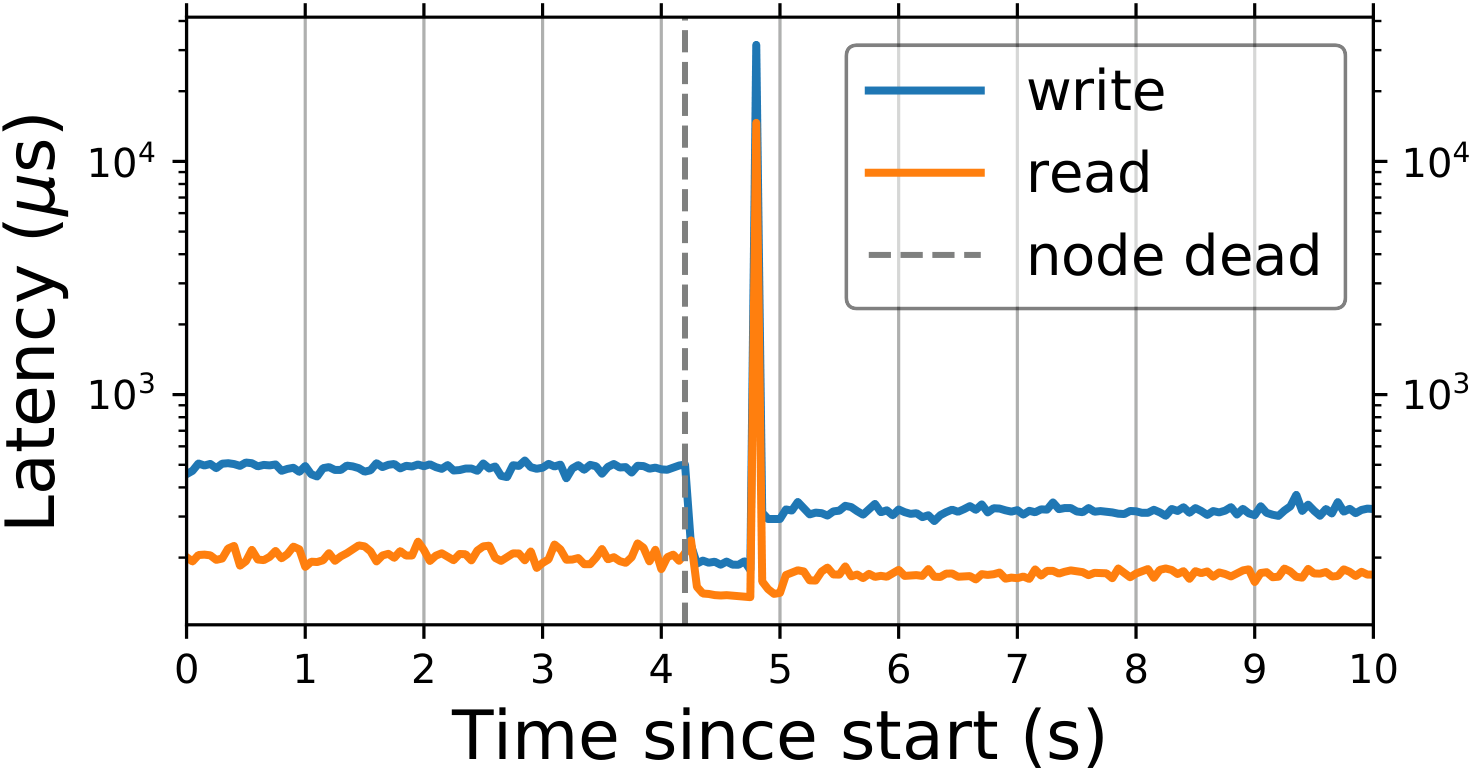
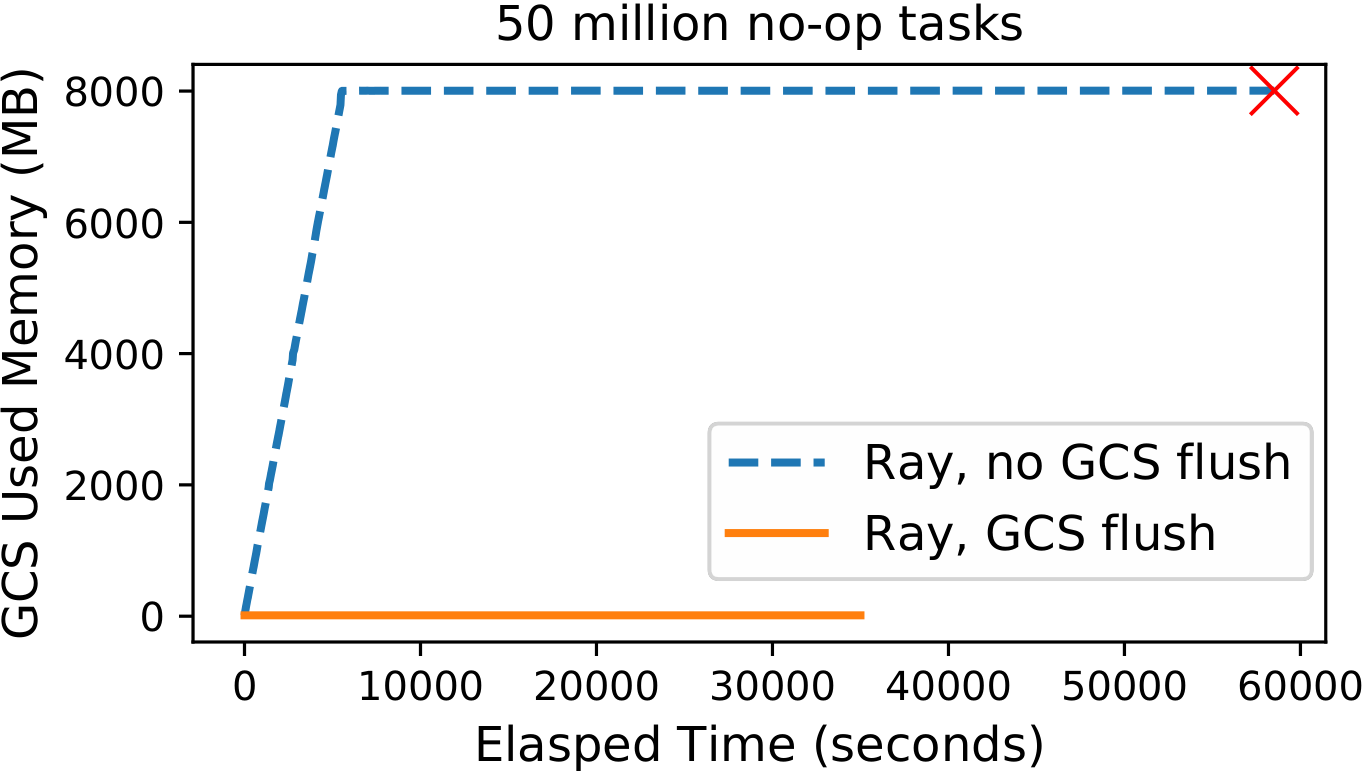
图 10:Ray GCS 的容错与刷新。(a) 链以 2 个副本启动。我们手动触发如下重配置:在 t ≈ 4.2s 杀掉一个链成员;紧接着新链成员加入、发起状态转移,并将链恢复为 2 副本。尽管发生重配置,客户端可观测的最大延迟仍低于 30ms。(b) Ray GCS 通过 GCS 刷新保持恒定内存占用。不刷新时,内存占用达到系统容量上限,工作负载无法在预定时间内完成(红色叉号)。
GCS 刷新。 Ray 具备定期把 GCS 内容刷新到磁盘的能力。在图 10b 中,我们顺序提交 5000 万个空任务并监控 GCS 内存消耗。如预期,内存随被跟踪任务数线性增长,最终达到系统内存容量。那时系统停滞,工作负载无法在合理时间内完成。周期性 GCS 刷新带来两个收益:第一,内存占用被限制在用户可配置的级别(该微基准中我们采用激进策略,尽量把内存消耗压到最低);第二,刷新机制为长时运行的 Ray 应用提供了一种把血缘快照到磁盘的自然方式。
从任务故障中恢复。 在图 11a 中,我们演示了 Ray 利用持久化的 GCS 血缘存储,透明地从 Worker 节点故障中恢复并弹性伸缩的能力。该工作负载运行在 m4.xlarge 实例上,由 Driver 提交的、由 100ms 任务组成的线性链构成。当节点被移除时(在 25s、50s、100s),本地调度器重建链中先前的结果以继续执行。总体上,每节点吞吐在整个过程中保持稳定。
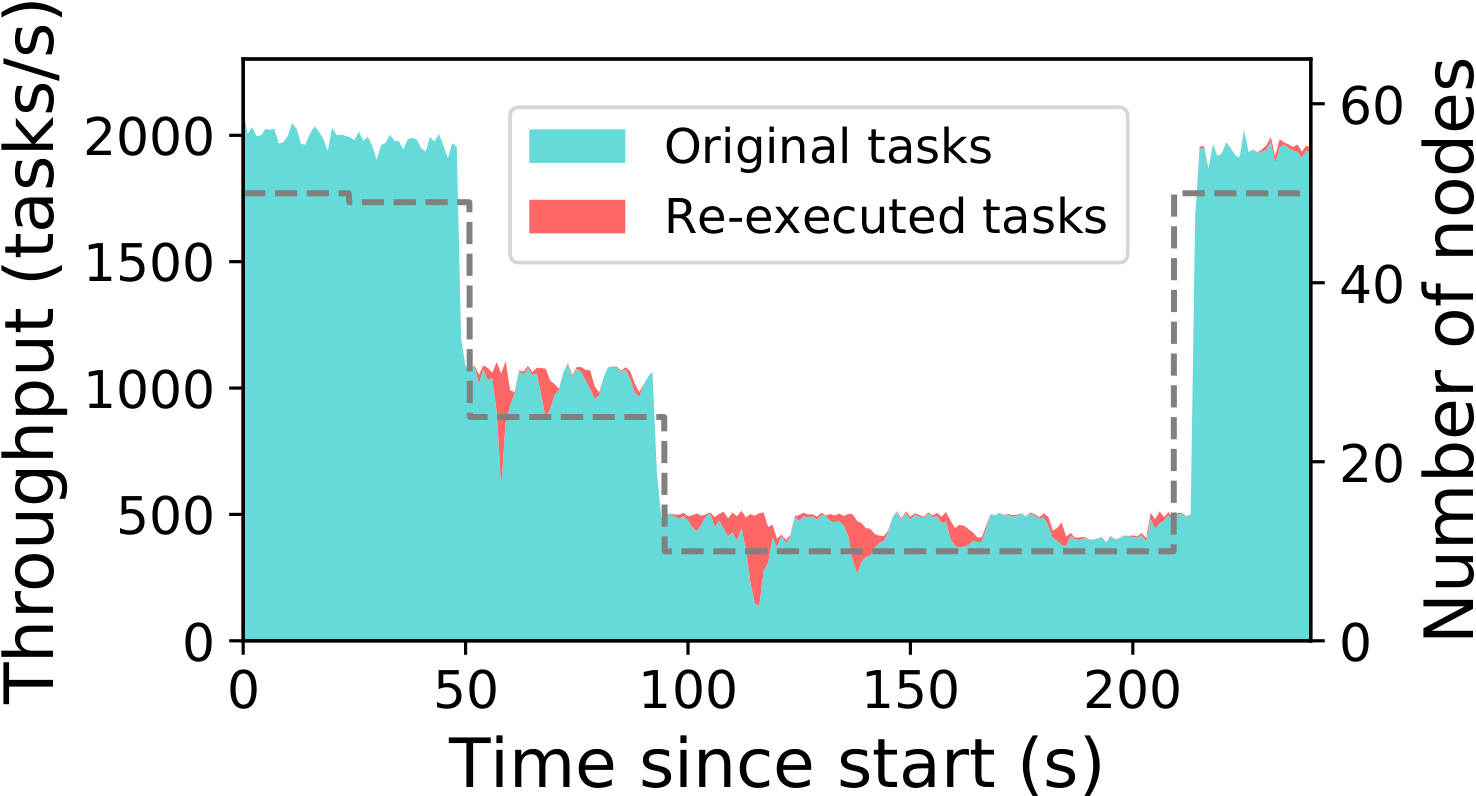
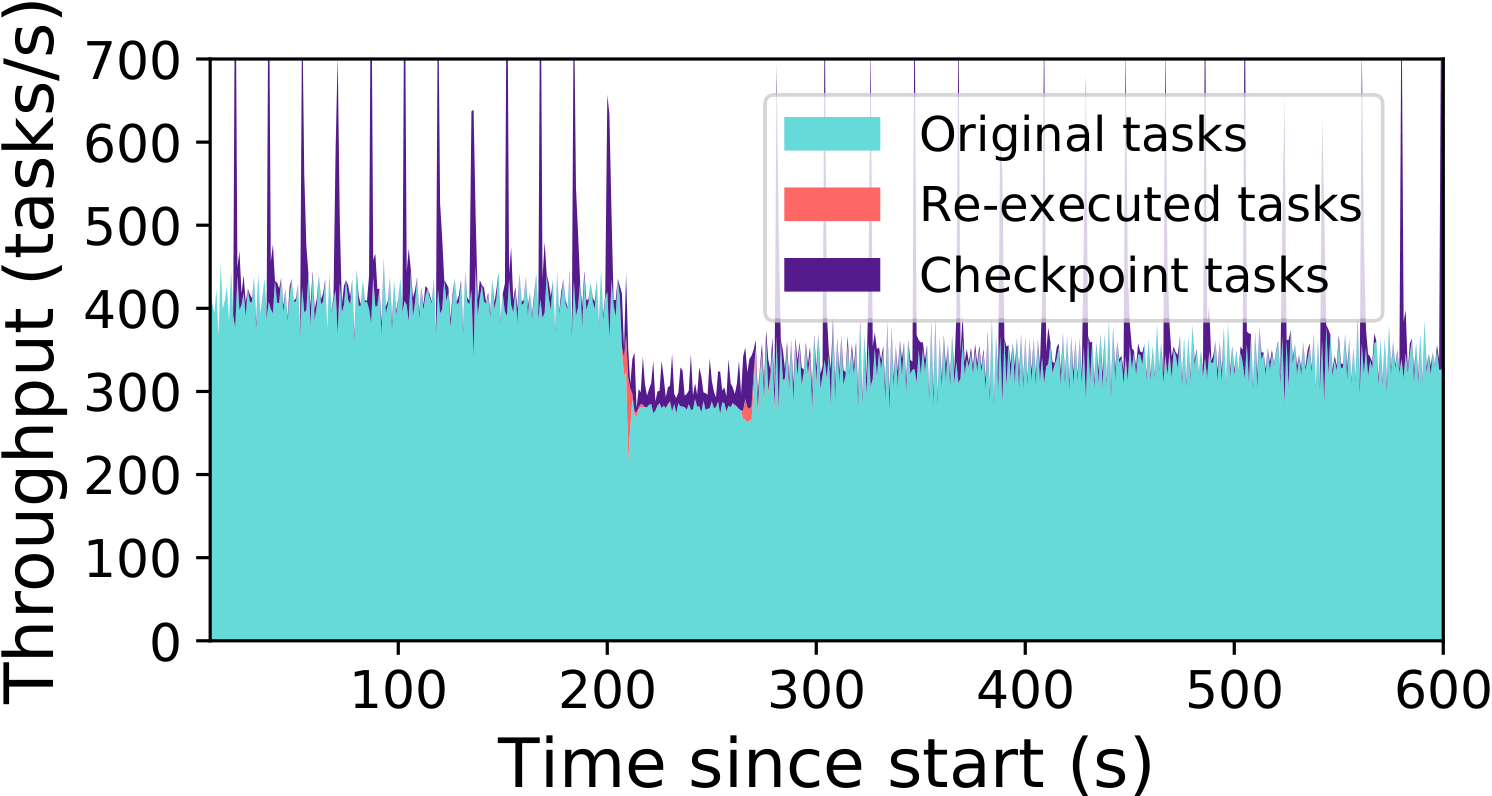
图 11:Ray 容错。(a) Ray 在节点被移除时(虚线)重建丢失的任务依赖,并在节点加回后恢复到原始吞吐。每个任务 100ms,且依赖先前提交的任务生成的对象。(b) Actor 从其最后一个检查点重建。在 t = 200s 时杀掉 10 个节点中的 2 个,集群中 2000 个 Actor 有 400 个在剩余节点上恢复(t = 200–270s)。
从 Actor 故障中恢复。 通过把 Actor 方法调用直接编码为依赖图中的有状态边,我们可以复用图 11a 中同样的对象重建机制,为有状态计算提供透明容错。Ray 还利用用户定义的检查点函数来约束 Actor 的重建时间(图 11b)。以极小的开销,检查点使只需重执行 500 个方法,而不做检查点则需要重执行 1 万个方法。未来我们希望进一步减少 Actor 重建时间,例如允许用户标注不修改状态的方法。
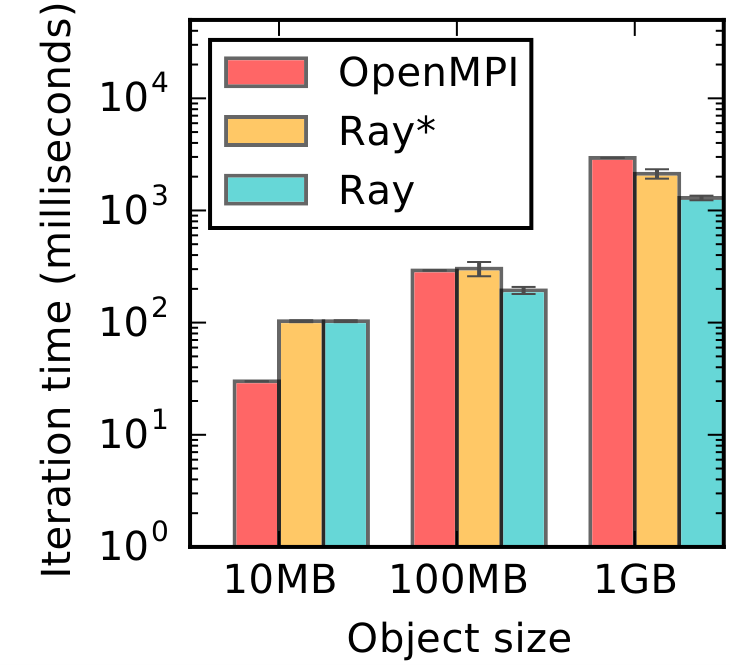
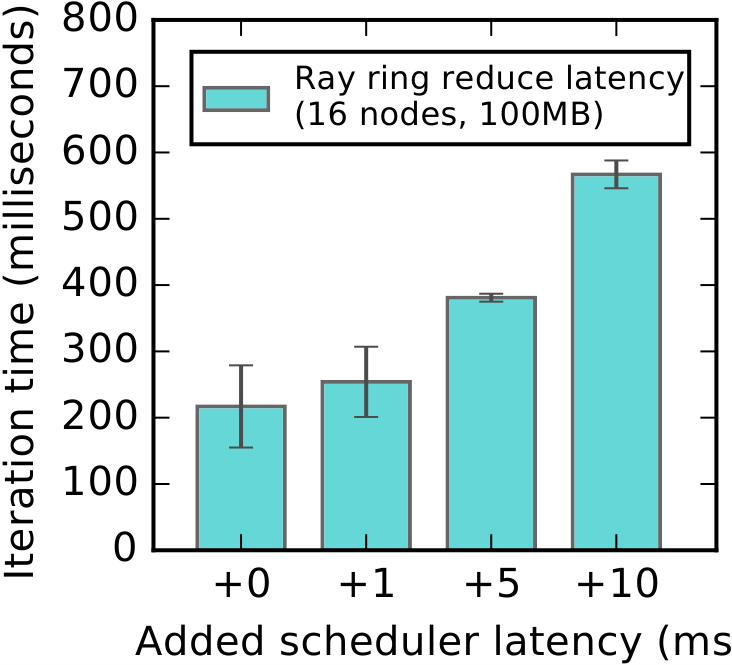
图 12:(a) 16 个 m4.16xl 节点上 allreduce 的平均执行时间。每个 Worker 运行在不同节点上。Ray* 把 Ray 限制为 1 个发送线程加 1 个接收线程。(b) Ray 的低延迟调度对 allreduce 至关重要。
Allreduce。 Allreduce 是对许多机器学习负载都很重要的分布式通信原语。这里我们评估 Ray 是否能以足够低的开销原生支持环状 allreduce [57] 实现,从而与现有实现 [53] 匹敌。我们发现 Ray 在 16 个节点上完成 100MB 的 allreduce 约需 200ms,1GB 约需 1200ms——出人意料地分别比流行的 MPI 实现 OpenMPI(v1.10)快 1.5× 和 2×(图 12a)。我们把 Ray 的性能归因于其网络传输使用多线程,充分利用了 AWS 上节点之间 25Gbps 的连接,而 OpenMPI 在单线程上顺序地发送和接收数据 [22]。对于更小的对象,OpenMPI 通过切换到开销更低的算法胜过 Ray——这是我们计划在未来实现的优化。
Ray 的调度器性能对实现 allreduce 这类原语至关重要。在图 12b 中,我们注入人为的任务执行延迟,显示只要多出几毫秒延迟,性能就下降近 2×。Spark 和 CIEL 这类采用集中式调度器的系统,调度器开销通常在几十毫秒 [62, 38],使得此类负载不切实际。调度器吞吐也会成为瓶颈,因为环状 allreduce 所需任务数随参与者数量平方增长。
5.2 构建块
端到端应用(如 AlphaGo [54])要求训练、服务和仿真的紧耦合。本节把每种负载单独拿出来,放在一个能体现典型 RL 应用需求的环境中考察。由于面向 RL 的灵活编程模型,以及支撑该编程模型的系统,Ray 在这些单一负载上达到甚至有时超过了专用系统的性能。
5.2.1 分布式训练
我们利用 Ray 的 Actor 抽象表示模型副本,实现了数据并行的同步 SGD。模型权重通过 allreduce(5.1 节)或参数服务器同步,两者都构建在 Ray API 之上。
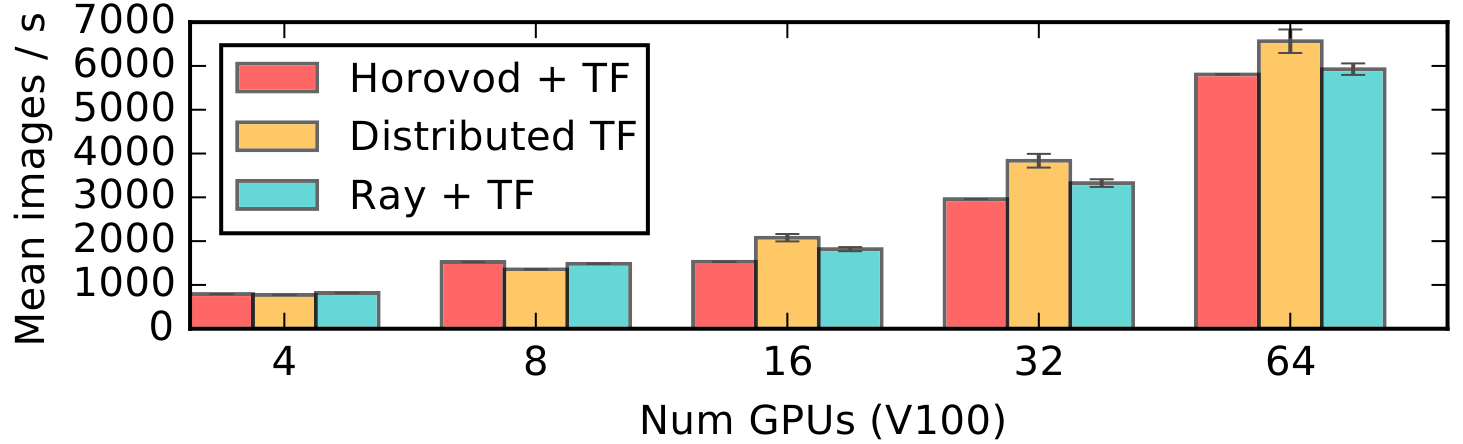
在图 13 中,我们评估 Ray 的(同步)参数服务器 SGD 实现与最先进实现 [53] 的性能,每项实验使用相同的 TensorFlow 模型和合成数据生成器。为准确度量 Ray 引入的开销,而非深度学习框架之间的差异,我们只与基于 TensorFlow 的系统比较。每次迭代中,模型副本 Actor 并行计算梯度,把梯度发送给分片的参数服务器,再从参数服务器读取求和后的梯度用于下一次迭代。
图 13 显示 Ray 与 Horovod 性能相当,与分布式 TensorFlow(distributed_replicated 模式)的差距在 10% 以内。这是因为在 Ray 的通用 API 中也能表达这些专用系统中同样的应用级优化。其中一项关键优化是在单次迭代内对梯度计算、传输和求和做流水线化。为把 GPU 计算与网络传输重叠,我们用一个自定义 TensorFlow 算子把张量直接写入 Ray 的对象存储。
5.2.2 服务
模型服务是端到端应用的重要组件。Ray 主要关注向同一动态任务图内运行的仿真器提供**嵌入式(embedded)**模型服务(例如 Ray 上的 RL 应用内部)。相比之下,Clipper [19] 这类系统专注于向外部客户端提供预测服务。
在这种场景下,低延迟对实现高利用率至关重要。为说明这一点,表 3 比较了用 Ray Actor 服务策略与通过 REST 使用开源 Clipper 系统的服务端吞吐。这里客户端和服务端进程共置在同一台机器上(一台 p3.8xlarge 实例)——RL 应用通常如此,而 Clipper 等系统面向的通用 Web 服务负载则不然。凭借低开销的序列化和共享内存抽象,对于输入较大、评估耗时 5ms 的小型全连接策略模型,Ray 达到了高一个数量级的吞吐;对于输入较小、类似 AlphaGo Zero 所用、评估更昂贵的残差网络策略模型,Ray 也更快。
表 3:专用服务系统 Clipper [19] 与 Ray 在两种嵌入式服务负载上的吞吐对比。
| 系统 | 小输入 | 较大输入 |
|---|---|---|
| Clipper | 4400 ± 15 states/sec | 290 ± 1.3 states/sec |
| Ray | 6200 ± 21 states/sec | 6900 ± 150 states/sec |
我们使用一个残差网络和一个小型全连接网络,评估分别耗时 10ms 和 5ms。服务器被以 64 为批量、分别发送 4KB 和 100KB 大小状态的客户端查询。
5.2.3 仿真
RL 中使用的仿真器产生长度可变的结果("timesteps"),由于与训练构成紧循环,这些结果必须一可用就被使用。任务异构性和时效性要求使仿真难以在 BSP 式系统中得到高效支持。作为演示,我们比较:(1) 一个 MPI 实现,在 n 个核上以 3 轮、轮间有全局栅栏的方式提交 3n 个并行仿真运行(注意专家可以用 MPI 的异步原语绕过栅栏,代价是程序复杂性增加;我们仍选择这种实现来模拟 BSP);(2) 一个 Ray 程序,发出同样的 3n 个任务,同时把仿真结果并发地收集回 Driver。表 4 显示两个系统都扩展良好,但 Ray 实现了最高 1.8× 的吞吐。这说明了一种能够动态产生并收集细粒度仿真任务结果的编程模型的价值。
表 4:OpenAI Gym [13] 中 Pendulum-v0 仿真器的每秒 timesteps。Ray 在大规模运行异构仿真时实现了更好的利用率。
| 系统、编程模型 | 1 CPU | 16 CPUs | 256 CPUs |
|---|---|---|---|
| MPI,批量同步 | 22.6K | 208K | 2.16M |
| Ray,异步任务 | 22.3K | 290K | 4.03M |
5.3 RL 应用
如果没有一个能紧耦合训练、仿真和服务步骤的系统,今天的强化学习算法只能实现为一次性的方案,难以纳入那些需要不同计算结构或使用不同架构的优化。于是,通过在 Ray 中实现两个代表性的强化学习应用,我们能够匹敌甚至超过专门为这些算法定制的系统。主要原因是 Ray 编程模型的灵活性:它能表达应用级优化——这些优化移植到定制系统需要大量工程努力——而 Ray 的动态任务图执行引擎则透明地支持它们。
5.3.1 进化策略
为评估 Ray 在大规模 RL 负载下的表现,我们实现了进化策略(Evolution Strategies,ES)算法,并与参考实现 [49] 比较——后者是专为该算法构建的系统,依赖 Redis 做消息传递、用低层多进程库做数据共享。该算法周期性地向一组 Worker 广播新策略,并聚合约 1 万个任务的结果(每个任务执行 10 到 1000 个仿真步)。
如图 14a 所示,Ray 上的实现扩展到 8192 个核。可用核数翻倍带来平均 1.6× 的完成时间加速。相反,专用系统在 2048 核时无法完成——此时系统中的工作量超过了应用 Driver 的处理能力。为避免这个问题,Ray 实现使用了一棵 Actor 聚合树,达到 3.7 分钟的中位时间,比已发表的最好结果(10 分钟)快两倍多。
用 Ray 对串行实现做初始并行化只需要修改 7 行代码。通过分层聚合实现性能提升,借助 Ray 对嵌套任务和 Actor 的支持很容易做到。相比之下,参考实现有数百行代码专门用于 Worker 之间通信任务和数据的协议,而且要支持分层聚合这样的优化还需要进一步的工程工作。
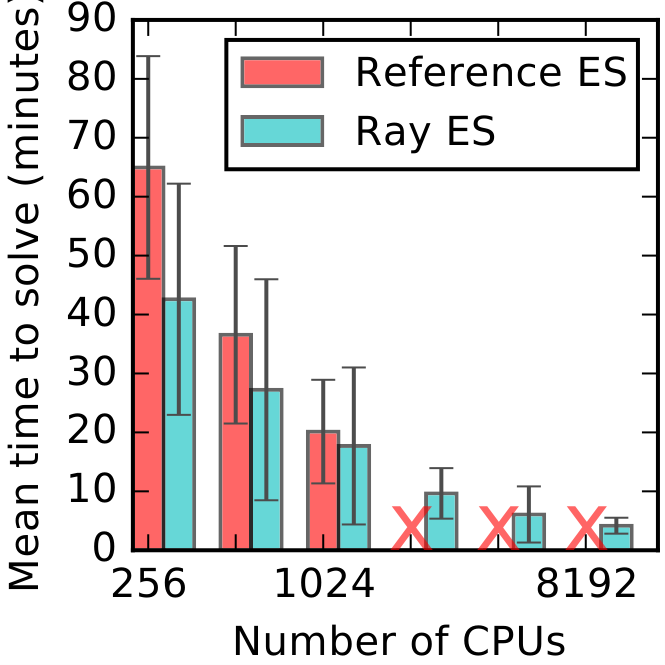
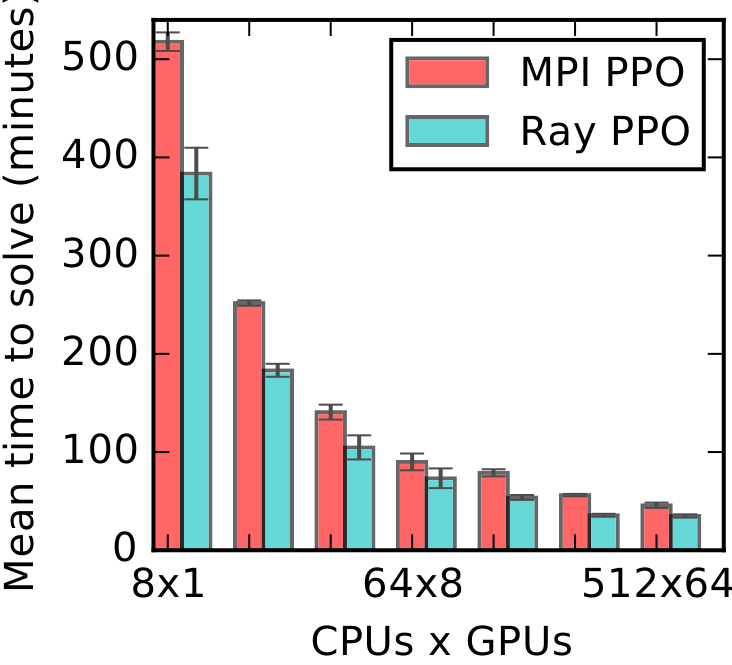
图 14:Humanoid-v1 任务 [13] 上达到 6000 分所需的时间。(a) Ray 的 ES 实现良好扩展到 8192 核,中位时间 3.7 分钟,比已发表的最好结果快两倍多。专用系统无法在 1024 核以上运行。ES 在此基准上比 PPO 快,但运行时方差更大。(b) Ray 的 PPO 实现用更少的 GPU、以一小部分成本超过了专用的 MPI 实现 [5]。MPI 实现每 8 个 CPU 需要 1 块 GPU,而 Ray 版本最多需要 8 块 GPU(且每 8 个 CPU 从不超过 1 块 GPU)。
5.3.2 近端策略优化
我们在 Ray 中实现了近端策略优化(Proximal Policy Optimization,PPO)[51],并与使用 OpenMPI 通信原语的高度优化参考实现 [5] 比较。该算法是异步的 scatter-gather:当仿真 Actor 向 Driver 返回 rollout 时,新任务被分配给它。持续提交任务直到收集到 32 万个仿真步(每个任务产生 10 到 1000 步)。策略更新执行 20 步 SGD,批量大小 32768。本例中模型参数约 350KB。这些实验使用 p2.16xlarge(GPU)和 m4.16xlarge(高 CPU)实例。
如图 14b 所示,Ray 实现在所有实验中都超过了优化的 MPI 实现,同时只用了其一小部分 GPU。原因是 Ray 感知异构性,允许用户以单个任务或 Actor 的粒度表达资源需求,从而利用非对称架构。Ray 实现进而可以利用 TensorFlow 的单进程多 GPU 支持,并尽可能把对象固定在 GPU 内存中。由于需要把 rollout 异步收集到单一 GPU 进程,这一优化很难移植到 MPI。事实上,[5] 包含两个定制的 PPO 实现:一个用 MPI 面向大集群,一个为 GPU 优化但仅限单节点。Ray 允许一个实现同时适用于两种场景。
Ray 处理资源异构的能力还把 PPO 的成本降低了 4.5 倍 [4],因为纯 CPU 任务可以被调度到更便宜的高 CPU 实例上。相比之下,MPI 应用通常表现出对称架构:所有进程运行相同代码、需要相同资源,这就无法使用纯 CPU 机器做水平扩展。此外,MPI 实现需要按需(on-demand)实例,因为它不能透明地处理故障。假设 spot 实例便宜 4 倍,Ray 的容错与资源感知调度合计把成本降低了 18 倍。
6 相关工作
动态任务图。 Ray 与 CIEL [40] 和 Dask [48] 关系密切。三者都支持带嵌套任务的动态任务图,并实现 future 抽象。CIEL 同样提供基于血缘的容错,而 Dask 与 Ray 一样与 Python 完全集成。然而 Ray 在两个具有重要性能意义的方面有所不同。第一,Ray 用 Actor 抽象扩展了任务模型。这对分布式训练和服务中高效的有状态计算是必要的,它使模型数据与计算同址。第二,Ray 采用完全分布式、解耦的控制面与调度器,而不是依赖存储所有元数据的单一 master。这对在不修改系统的情况下高效支持 allreduce 等原语至关重要。16 节点 100MB 峰值性能下,Ray 上的 allreduce(第 5.1 节)在 200ms 内提交 32 轮、每轮 16 个任务。而 Dask 报告在 512 核上最大调度器吞吐为 3k 任务/秒 [3]。采用集中式调度器的话,allreduce 每轮将产生至少约 5ms 的调度延迟,意味着完成时间最多差 2×(图 12b)。即使调度器去中心化,把控制面信息与调度器耦合也会让后者停留在数据传输的关键路径上,给 allreduce 每一轮增加一次额外的往返。
数据流系统。 MapReduce [20]、Spark [65] 和 Dryad [28] 等流行数据流系统在分析和 ML 负载上被广泛采用,但它们的计算模型对细粒度、动态的仿真负载限制太大。Spark 和 MapReduce 实现 BSP 执行模型,假定同一阶段内的任务执行相同计算且耗时大致相同。Dryad 放宽了这一限制,但缺少对动态任务图的支持。此外,这些系统都不提供 Actor 抽象,也没有实现分布式可扩展的控制面与调度器。最后,Naiad [39] 是一种为某些负载提供更好可扩展性的数据流系统,但只支持静态任务图。
机器学习框架。 TensorFlow [7] 和 MXNet [18] 面向深度学习负载,能高效利用 CPU 和 GPU。对于由线性代数操作组成的静态 DAG 构成的训练负载,它们能取得很好的性能,但对把训练与仿真及嵌入式服务紧耦合所需的更通用计算支持有限。TensorFlow Fold [33] 提供了一些对动态任务图的支持,MXNet 也通过其内部 C++ API 提供部分支持,但两者都不完全支持在执行期间根据任务进度、任务完成时间或故障修改 DAG。TensorFlow 和 MXNet 原则上通过允许程序员模拟底层消息传递和同步原语来实现通用性,但此时的陷阱和用户体验与 MPI 类似。OpenMPI [22] 可以达到高性能,但编程相对困难,因为它需要显式协调来处理异构和动态任务图。此外,它迫使程序员显式处理容错。
Actor 系统。 Orleans [14] 和 Akka [1] 是两个非常适合开发高可用、高并发分布式系统的 Actor 框架。然而与 Ray 相比,它们对数据丢失恢复的支持较弱。要恢复有状态 Actor,Orleans 开发者必须显式检查点 Actor 状态和中间响应。Orleans 中的无状态 Actor 可以复制以扩展规模,因此可以充当任务,但与 Ray 不同,它们没有血缘。类似地,Akka 虽然显式支持跨故障持久化 Actor 状态,但不为无状态计算(即任务)提供高效容错。消息投递方面,Orleans 提供 at-least-once 语义,Akka 提供 at-most-once 语义。相比之下,Ray 提供透明容错和 exactly-once 语义,因为每次方法调用都记录在 GCS 中,且参数和结果都不可变。我们发现实践中这些限制并不影响应用的性能。Erlang [10] 和 C++ Actor Framework [17]——另外两个基于 Actor 的系统——对容错的支持同样有限。
全局控制存储与调度。 逻辑上集中控制面的概念此前已在软件定义网络(SDN)[16]、分布式文件系统(如 GFS [23])、资源管理(如 Omega [52])和分布式框架(如 MapReduce [20]、BOOM [9])等领域提出。Ray 从这些开创性工作中汲取灵感,但有显著改进。与 SDN、BOOM 和 GFS 不同,Ray 把控制面信息(如 GCS)的存储与逻辑实现(如调度器)解耦。这使得存储层和计算层都能独立扩展,是实现我们可扩展性目标的关键。Omega 使用调度器通过全局共享状态协调的分布式架构。在这一架构之上,Ray 增加了全局调度器以在本地调度器之间平衡负载,并把目标定为毫秒级而非秒级的任务调度。
Ray 实现了一种独特的分布式自底向上调度器,可水平扩展,并能处理动态构建的任务图。与 Ray 不同,大多数现有集群计算系统 [20, 64, 40] 采用集中式调度器架构。Sparrow [45] 虽然是去中心化的,但其调度器各自独立决策,限制了可行的调度策略空间,且同一作业的所有任务都由同一个全局调度器处理。Mesos [26] 实现两级层次调度器,但其顶层调度器管理的是框架而非单个任务。Canary [47] 通过让每个调度器实例处理任务图的一部分取得了令人瞩目的性能,但不处理动态计算图。Cilk [12] 是一种并行编程语言,其 work-stealing 调度器为动态任务图实现了可证明高效的负载均衡。然而,如果没有像 Ray 全局调度器这样的中央协调者,这种完全并行的设计也很难扩展到分布式环境并支持数据局部性和资源异构。
7 讨论与经验
构建 Ray 是一段漫长的旅程。它始于两年前一个用于分布式训练和仿真的 Spark 库。然而 BSP 模型相对僵化、每任务开销高、缺少 Actor 抽象,促使我们开发了一个新系统。自大约一年前发布 Ray 以来,已有数百人使用过它,若干公司已在生产环境中运行它。这里我们讨论开发和使用 Ray 的经验,以及一些早期用户反馈。
API。 在 API 设计上,我们强调极简。最初我们只有一个基本的任务抽象。后来,为适配持续时间异构的 rollout,我们加入了 wait() 原语;为适配第三方仿真器并摊销昂贵的初始化开销,我们加入了 Actor 抽象。虽然最终得到的 API 相对底层,但它已被证明既强大又简单易用。我们已经用这个 API 在 Ray 之上实现了许多最先进的 RL 算法,包括 A3C [36]、PPO [51]、DQN [37]、ES [49]、DDPG [55] 和 Ape-X [27]。在大多数情况下,我们只用几十行代码就把这些算法移植到了 Ray。基于早期用户反馈,我们正在考虑为 API 增加更高层的原语和库,它们也可以为调度决策提供信息。
局限性。 鉴于负载的通用性,专门的优化很难做。例如,我们必须在不完全了解计算图的情况下做出调度决策。Ray 中的调度优化可能需要更复杂的运行时性能分析。此外,为每个任务存储血缘要求实现垃圾回收策略,以约束 GCS 中的存储成本——这是我们正在积极开发的功能。
容错。 我们经常被问到:AI 应用真的需要容错吗?毕竟,由于许多 AI 算法的统计性质,直接忽略失败的 rollout 不就行了。根据我们的经验,答案是"需要"。第一,能够忽略故障使应用更容易编写和推理。第二,我们通过确定性重放实现容错的方案极大简化了调试,因为它使我们能轻易复现大多数错误——这一点尤其重要,因为 AI 算法由于其随机性而出了名地难调试。第三,容错有助于省钱,因为它允许我们在 AWS spot 实例这类廉价资源上运行。当然,这是以一定开销为代价的。不过我们发现,对于目标负载而言这一开销很小。
GCS 与水平可扩展性。 GCS 极大简化了 Ray 的开发和调试。调试 Ray 本身时,我们能查询整个系统的状态,而不必手动暴露内部组件的状态。此外,GCS 也是我们时间线可视化工具的后端,用于应用级调试。
GCS 对 Ray 的水平可扩展性也至关重要。在第 5 节中,只要 GCS 成为瓶颈,我们就能通过增加更多分片来扩展。GCS 还让全局调度器只需增加更多副本就能扩展。基于这些优势,我们相信集中控制状态将成为未来分布式系统的一个关键设计组件。
8 结论
今天还没有通用系统能高效支撑训练、服务和仿真的紧循环。为表达这些核心构建块并满足新兴 AI 应用的需求,Ray 在单一动态任务图中统一了任务并行与 Actor 编程模型,并采用了由全局控制存储和自底向上分布式调度器支撑的可扩展架构。该架构同时实现了编程灵活性、高吞吐与低延迟,这对新兴的 AI 负载尤为重要——这些负载所产生的任务在资源需求、持续时间和功能上都千差万别。我们的评估展示了每秒 180 万任务以内的线性可扩展性、透明容错,以及在若干当代 RL 负载上的显著性能提升。因此,Ray 为未来 AI 应用的开发提供了灵活性、性能与易用性的强大组合。
致谢
本研究部分受 NSF CISE Expeditions 奖项 CCF-1730628 以及 Alibaba、Amazon Web Services、Ant Financial、Arm、CapitalOne、Ericsson、Facebook、Google、Huawei、Intel、Microsoft、Scotiabank、Splunk 和 VMware 的捐赠支持,并受 NSF 资助 DGE-1106400。我们感谢匿名审稿人和我们的 shepherd Miguel Castro 的周到反馈,它们帮助提升了本文质量。
参考文献
- Akka. https://akka.io/.
- Apache Arrow. https://arrow.apache.org/.
- Dask Benchmarks. http://matthewrocklin.com/blog/work/2017/07/03/scaling.
- EC2 Instance Pricing. https://aws.amazon.com/ec2/pricing/on-demand/.
- OpenAI Baselines: high-quality implementations of reinforcement learning algorithms. https://github.com/openai/baselines.
- TensorFlow Serving. https://www.tensorflow.org/serving/.
- Abadi, M., et al. TensorFlow: A system for large-scale machine learning. OSDI 2016.
- Agarwal, A., et al. A multiworld testing decision service. arXiv:1606.03966 (2016).
- Alvaro, P., et al. BOOM Analytics: exploring data-centric, declarative programming for the cloud. EuroSys 2010.
- Armstrong, J., Virding, R., Wikström, C., Williams, M. Concurrent programming in ERLANG.
- Beattie, C., et al. DeepMind Lab. arXiv:1612.03801 (2016).
- Blumofe, R. D., Leiserson, C. E. Scheduling multithreaded computations by work stealing. J. ACM 46, 5 (1999).
- Brockman, G., et al. OpenAI Gym. arXiv:1606.01540 (2016).
- Bykov, S., et al. Orleans: Cloud computing for everyone. SOCC 2011.
- Carbone, P., et al. State management in Apache Flink. Proc. VLDB Endow. 10, 12 (2017).
- Casado, M., et al. Ethane: Taking control of the enterprise. SIGCOMM 2007.
- Charousset, D., et al. Native actors: A scalable software platform for distributed, heterogeneous environments. 2013.
- Chen, T., et al. MXNet: A flexible and efficient machine learning library for heterogeneous distributed systems. LearningSys'16.
- Crankshaw, D., et al. Clipper: A low-latency online prediction serving system. NSDI 2017.
- Dean, J., Ghemawat, S. MapReduce: Simplified data processing on large clusters. Commun. ACM 51, 1 (2008).
- Dennis, J. B., Misunas, D. P. A preliminary architecture for a basic data-flow processor. ISCA 1975.
- Gabriel, E., et al. Open MPI: Goals, concept, and design of a next generation MPI implementation. 2004.
- Ghemawat, S., Gobioff, H., Leung, S.-T. The Google file system. 2003.
- Gonzalez, J. E., et al. GraphX: Graph processing in a distributed dataflow framework. OSDI 2014.
- Gu, S., et al. Deep reinforcement learning for robotic manipulation with asynchronous off-policy updates. ICRA 2017.
- Hindman, B., et al. Mesos: A platform for fine-grained resource sharing in the data center. NSDI 2011.
- Horgan, D., et al. Distributed prioritized experience replay. ICLR 2018.
- Isard, M., et al. Dryad: Distributed data-parallel programs from sequential building blocks. EuroSys 2007.
- Jia, Y., et al. Caffe: Convolutional architecture for fast feature embedding. arXiv:1408.5093 (2014).
- Jordan, M. I., Mitchell, T. M. Machine learning: Trends, perspectives, and prospects. Science 349, 6245 (2015).
- Leibiusky, J., Eisbruch, G., Simonassi, D. Getting Started with Storm. O'Reilly, 2012.
- Li, M., et al. Scaling distributed machine learning with the parameter server. OSDI 2014.
- Looks, M., et al. Deep learning with dynamic computation graphs. arXiv:1702.02181 (2017).
- Low, Y., et al. GraphLab: A new framework for parallel machine learning. UAI 2010.
- Malewicz, G., et al. Pregel: A system for large-scale graph processing. SIGMOD 2010.
- Mnih, V., et al. Asynchronous methods for deep reinforcement learning. ICML 2016.
- Mnih, V., et al. Human-level control through deep reinforcement learning. Nature 518, 7540 (2015).
- Murray, D. A Distributed Execution Engine Supporting Data-dependent Control Flow. University of Cambridge, 2012.
- Murray, D. G., et al. Naiad: A timely dataflow system. SOSP 2013.
- Murray, D. G., et al. CIEL: A universal execution engine for distributed data-flow computing. NSDI 2011.
- Nair, A., et al. Massively parallel methods for deep reinforcement learning. 2015.
- Ng, A., et al. Autonomous inverted helicopter flight via reinforcement learning. Experimental Robotics IX (2006).
- Nishihara, R., et al. Real-time machine learning: The missing pieces. HotOS 2017.
- OpenAI. OpenAI Dota 2 1v1 bot. https://openai.com/the-international/, 2017.
- Ousterhout, K., et al. Sparrow: Distributed, low latency scheduling. SOSP 2013.
- Paszke, A., et al. Automatic differentiation in PyTorch. 2017.
- Qu, H., et al. Canary: A scheduling architecture for high performance cloud computing. arXiv:1602.01412 (2016).
- Rocklin, M. Dask: Parallel computation with blocked algorithms and task scheduling. SciPy 2015.
- Salimans, T., et al. Evolution strategies as a scalable alternative to reinforcement learning. arXiv:1703.03864 (2017).
- Sanfilippo, S. Redis: An open source, in-memory data structure store. https://redis.io/, 2009.
- Schulman, J., et al. Proximal policy optimization algorithms. arXiv:1707.06347 (2017).
- Schwarzkopf, M., et al. Omega: Flexible, scalable schedulers for large compute clusters. EuroSys 2013.
- Sergeev, A., Del Balso, M. Horovod: fast and easy distributed deep learning in TensorFlow. arXiv:1802.05799 (2018).
- Silver, D., et al. Mastering the game of Go with deep neural networks and tree search. Nature 529, 7587 (2016).
- Silver, D., et al. Deterministic policy gradient algorithms. ICML 2014.
- Sutton, R. S., Barto, A. G. Reinforcement Learning: An Introduction. MIT Press, 1998.
- Thakur, R., Rabenseifner, R., Gropp, W. Optimization of collective communication operations in MPICH. IJHPCA 19, 1 (2005).
- Tian, Y., et al. ELF: An extensive, lightweight and flexible research platform for real-time strategy games. NIPS 2017.
- Todorov, E., Erez, T., Tassa, Y. Mujoco: A physics engine for model-based control. IROS 2012.
- Van Den Berg, J., et al. Superhuman performance of surgical tasks by robots using iterative learning from human-guided demonstrations. ICRA 2010.
- Van Renesse, R., Schneider, F. B. Chain replication for supporting high throughput and availability. OSDI 2004.
- Venkataraman, S., et al. Drizzle: Fast and adaptable stream processing at scale. SOSP 2017.
- White, T. Hadoop: The Definitive Guide. O'Reilly, 2012.
- Zaharia, M., et al. Resilient distributed datasets: A fault-tolerant abstraction for in-memory cluster computing. NSDI 2012.
- Zaharia, M., et al. Apache Spark: A unified engine for big data processing. Commun. ACM 59, 11 (2016).