具身智能基础设施:infra for EAI
具身智能往往分成本体、模型和数据。目前世界模型可以期待的最大 use case 也是在机器人相关的具身上。市场上这些赛道的公司在短时间内吸引了近千亿的资本涌入,也有龙头公司比如宇树已经上市。和大模型不同,有互联网数据的数据可以用作预训练,具身需要的是多个传感器时间对齐,有关和世界交互,携带深度空间信息的数据,这样的数据相比互联网数据少了几个数量级。业内的一个共识是具身的主要瓶颈是数据。
和自动驾驶已经是向有几十年积累的汽车行业销售不同,具身的主要市场仍然是科研。领先的学术界和工业界机构会去采购机器人,灵巧手以及各种传感器,采集套件等等去探索各条技术路线。虽然市场很小,但是具身或者物理 AI 有无比巨大的潜在市场。正如 Jürgen Schmidhuber 所说,真正的屏幕后的,通过图灵测试,能解决无数数学和编程问题的大模型还不是 AGI,可以让机器人操纵环境中的工具,自我修复,进化迭代的机械文明才是真的 AGI 。大约 30% 的宇树机器人就用来采集数据,灵巧手的头部公司比如 Shapa 和 WuJi 也频繁作为各种论文的演示工具。
所以面对一个快速增长的科研市场,具身的 data infra 或者 infra in general 的主要目的就是支持 Research 团队发现和定位问题,实验想法以支撑快速迭代。具体来说 infra 的 dual mandate 是:
- 提升总体产品的迭代速度:尽最大可能支持硬件算法以及其他部门的问题定位反馈和实验,以工具为核心,有序高效得协同。核心的目标是提升开发体验。
- 通过长期和提前的设计和合理的经济模型,来提升算力存储的使用效率,给财务预算规划带来确定性。核心的目标是争取到当前预算下性能成本达到帕累托最优。
承担如下职能:
- 支持对正在开发的自研硬件做出需求反馈和问题定位,如灵活面对数采 Kit 各个 component 的迭代和支持运营中 SOP 的执行
- 构建直观自然,有序的数据获取方案,可以快速高效得获取到想要的数据
- 拟定算力存储的 co location 方案,选择最合适的数据传输路径和 memory hierarchy
下简述一些 infra 的选型和解释,来支持上边的目标
data pipeline:, rustfs, pigsty
具身数据管线会把自采或者外部的原始数据经过标注,清洗以后转化为训练可用的批处理格式,也是 data infra 的核心
data pipeline 分为如下几个部分:
ingest:capture app/kit
- https://github.com/dora-rs/dora
- dora 是一个 Rust 框架,每个传感器只要声明式得接入,可以享受到比 ROS 更优的性能以及零拷贝数据传输,相比于 ROS 只能用在 ubuntu 系统上,dora 还有更好的兼容性。使用特殊指令集和系统的物联网设备盒子以及手机都可以更容易接入
- 性能关乎数采 Space (电脑/盒子)的性能,成本和散热还有稳定性,所以采集软件使用 Dora 会可以提升数采员的效率
- 在自采数据不 ready 的状态时,或者说是希望在非自采数据做评测时,可以在 https://datasets.gurasees.com/ 使用公开/开源数据集
标注/处理:ray 和 prefect for 标注模型集成
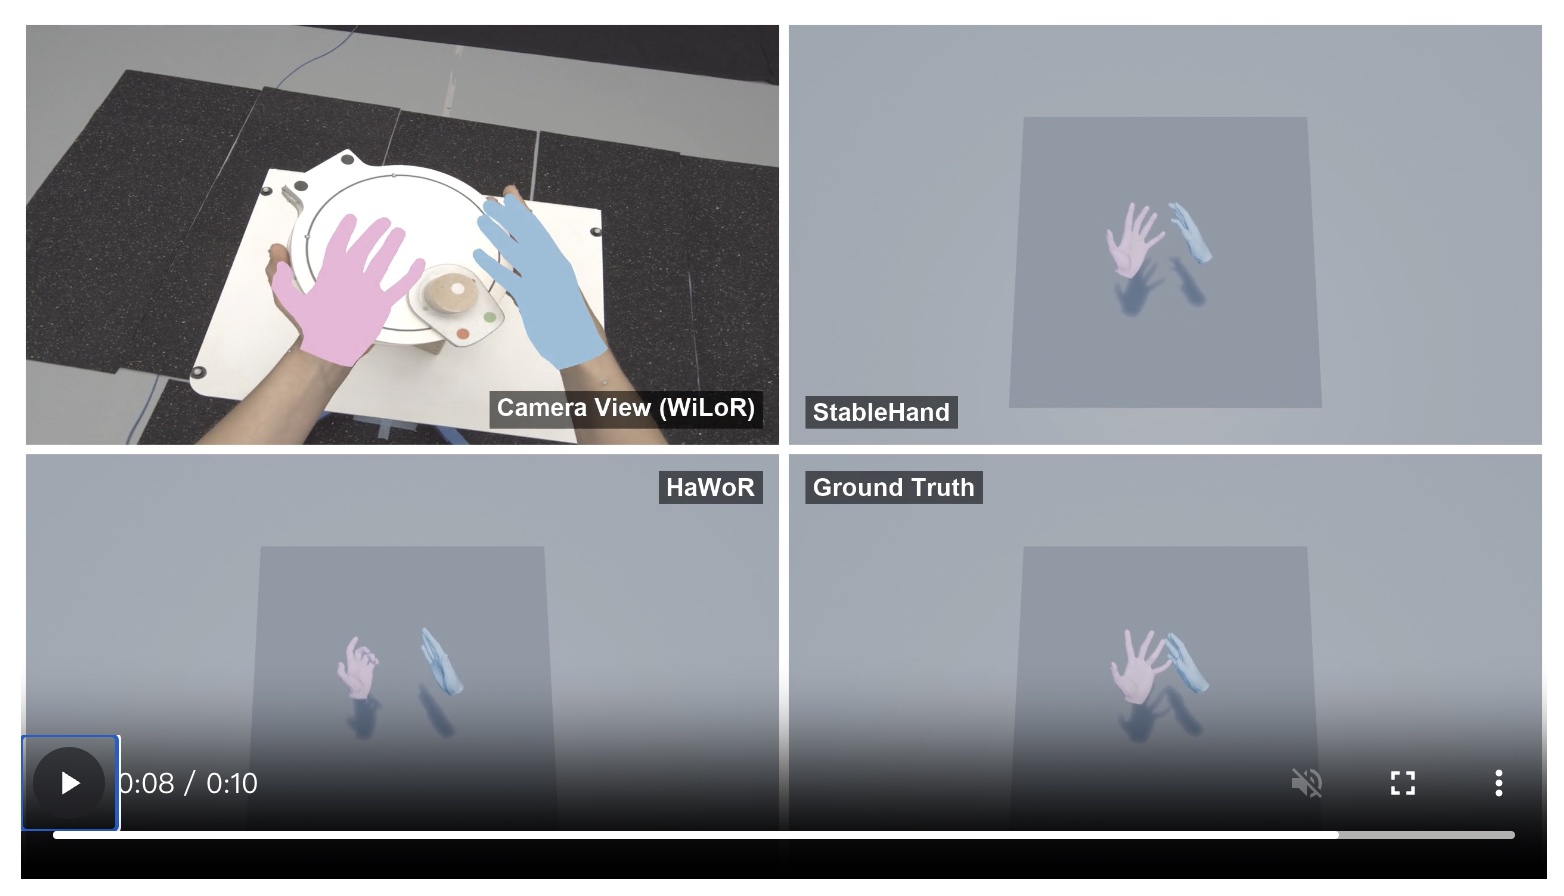
具身的数据是不可能脱离视觉存在的,视觉的数据打标模型有很多开源的工作, SOTA 是 StableHands, 从 WiLor 和 HaWor 传承下来的工作。视觉处理管线上对于丢手多手,腕部精度,视频编解码效率等等都有优化空间。
- Ray 可以帮助开发者自动调度各种 AI/ML 工作负载背后的硬件,快速集成各种算法和高效利用已有的算力资源,自动处理扩缩容,和更自然简单得表达各个算子的业务逻辑结合。典型的 case 就是把采集软件输出的原始时序数据打包成 LeRobot 数据集。
- Prefect 可以提供整个的 Workflow 调度,来维持整个 DAG 计算任务的缓存与缓存命中,重试逻辑等等
数据库:single source of truth
有一个中心化的具身智能数据库的好处就在于,就是时刻都有一个 single source of truth 来去查找和筛选数据, 通过声明式得管理数据的各种状态,只需要按结果而非过程得理解,使用调度数据。数据库的原子是 .rrd 文件,可以高效得存储时间对齐的,跨模态的数据。比如将高频低码流的 IMU 数据和视频数据以 chunk 得形式存储在一起,可以支持 PB 级的 scale 和 byte 级的流式读取。
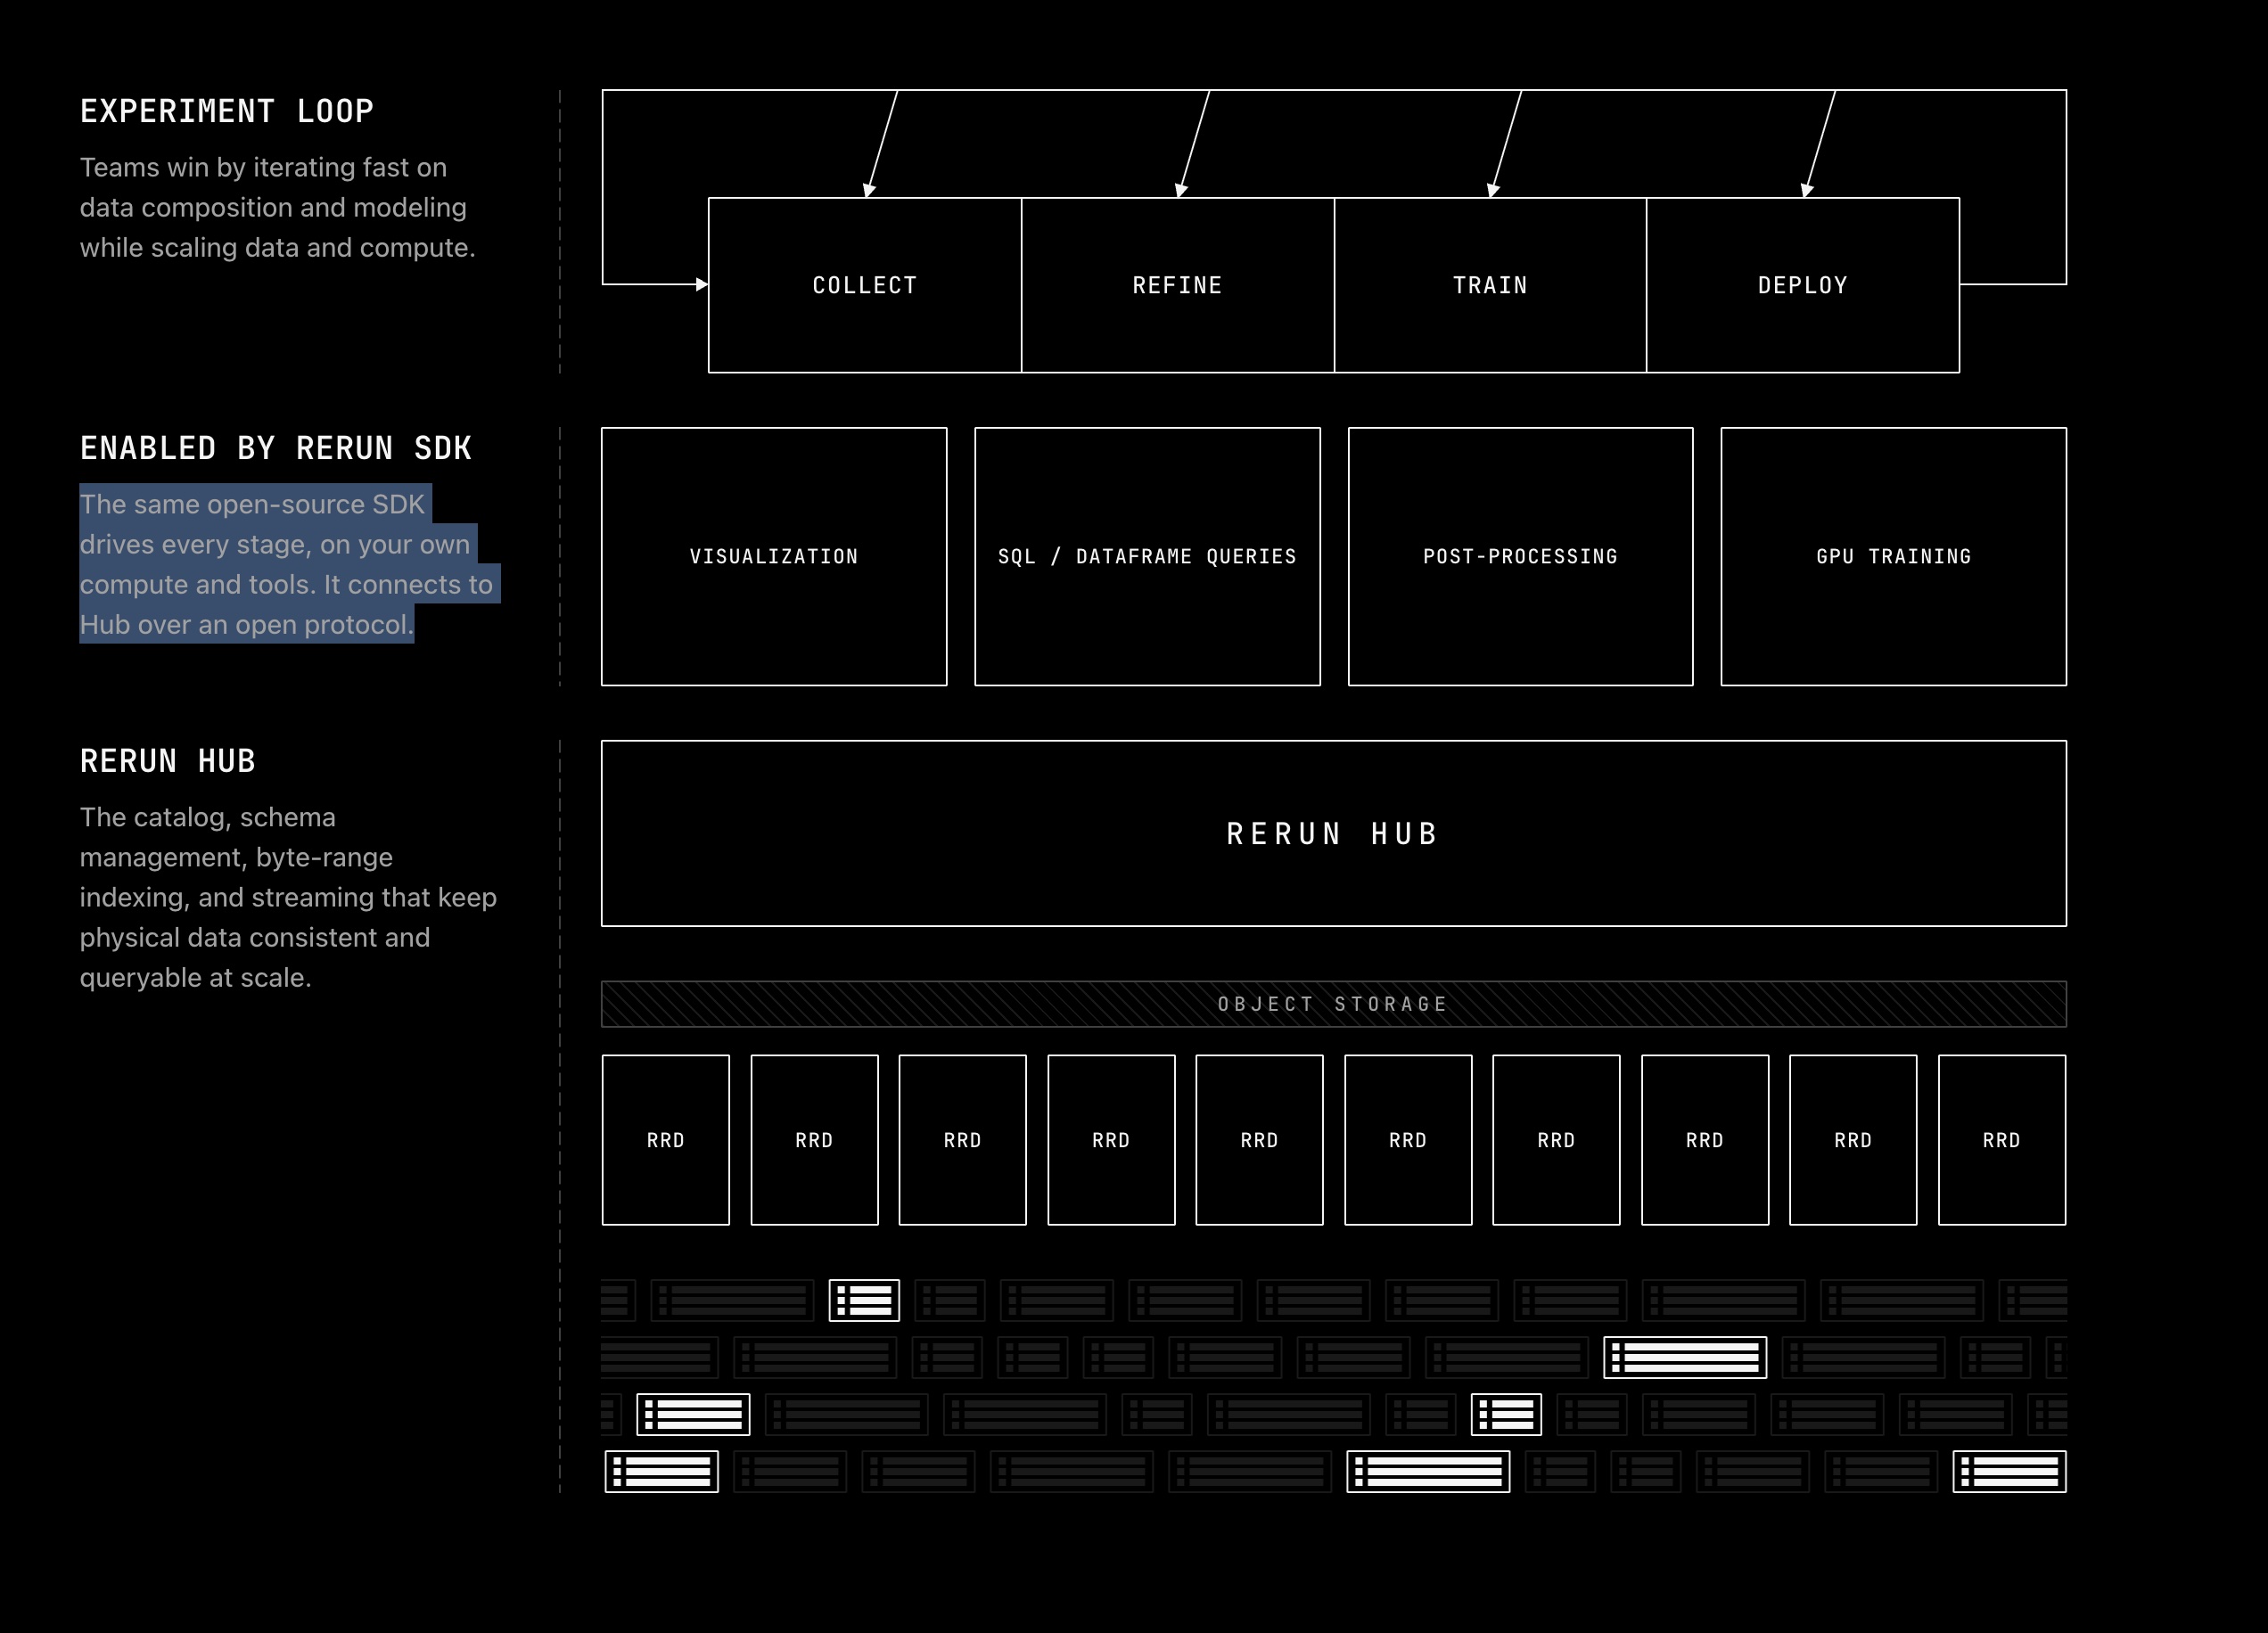
- Dataset View:一组 Rerun recording,每个 recording 通常是一个
.rrd文件,对应一个 segment,每个 segment 代表一次语义完整的任务。 - Table View :单独选取出某些模态的内容,以 Arrow 的形式返回语言无关,高效分析 ready 的数据。
lakefs 可以作为带版本的中心数据仓库,每次数据的使用通过 Tag ID 来关联到背后的分支,该分支 merge 的 status 以及对应的元数据。lakefs 可以作为 git 同语义的版本管理系统,提供最省空间的存储管理,支撑灵活的 data curation 。
- 主要参考的产品设计:https://rerun.io/hub, https://lakefs.io/ 还有 https://www.lancedb.com/
- 性能和原理分析:
- https://rerun.io/blog/data-layer-for-robot-learning
算力存储分配模型
- 算力分配上很多人更多关注的是 GPU 的利用率,但实际上更关注的应该是 以价值为权重的工作负载获得资源的频率。在 GPU 多是整租或者自建的当下,总 GPU 卡时很容易从财务口径计算。一个公平透明的 GPU 资源计价和获取流程,可以让公司各个小组不用在花大量的时间口头沟通GPU 的资源分配,甚至是出现因为资源抢占而有内部冲突的情形。
正如这篇文章所说 https://allenai.org/blog/impactful-scheduling
一个核心问题在于,用户往往比组织更了解自己作业的价值,但他们可能有动机隐藏这一价值,或在即使这样做会损害整体性能时仍紧握资源不放。例如,在 Ghodsi 等人 2011 年介绍 Dominant Resource Fairness 的论文中,他们讲述了一则轶事:一家搜索公司仅当用户能够保证高利用率时,才会为作业提供专用机器。他们很快发现,“用户会在代码中到处加入无限循环,以人为抬高利用率水平。”
之所以是 data infra 来负责算力规划是因为数据存储在什么样的路径,什么样的介质(全闪 or 混闪)是由 data infra 来指定的,还有数据采集,标注以及向训练交付的链路也是 data infra 设计的。而 compute 和 storage 又要 co location 相邻存放。