人类示范数据对具身智能有用吗
人类示范数据有没有用,是具身行业仍有争议的问题,也就是所谓的 "human to robot transfer"。两个显著使用了大量人类数据的 VLA 例子是英伟达的 egoscale(2 万小时)和蚂蚁灵波 2.0(1 万小时)。egoscale 完全使用人类数据做预训练,曾经在 2 月承诺开源,但现在悄悄下架了这个选项;灵波 2.0 里人类数据只占一小部分,另外还有 5 万小时真机数据。
egoscale 使用了 Sharpa 手,任务主要围绕卷衬衫、夹子夹东西、扑克牌发牌、开瓶子和注射;灵波 2.0 更多聚焦于普通家务任务,主要部署在夹爪上。
还有一些工作在说人类数据对世界模型训练的边际贡献并不大。在 300 到 30000 小时的数据 scale 中,模型准确地学到了手伸向哪里,但对手接触物体后会发生什么学习效果差了很多——因为接触、力和隐藏几何结构的信息并不存在于视觉里。
上边这份工作是在英伟达 Cosmos 世界模型上微调的。Nature Well 在数据量显著扩张(100 万小时 ego 人类数据)后有不同的结论。Nature Well 尤其突出的一个贡献在于这个模型着重于 20 DoF 灵巧手而非夹爪,完成了折叠材料、写书法,和在任务中更换工具。Nature Well 使用的是 ROKAE AR5 搭配 Wuji 手,主打了一些常见的家庭任务。因为灵巧手的模型比较少,可能 Nature Well 是第一家。
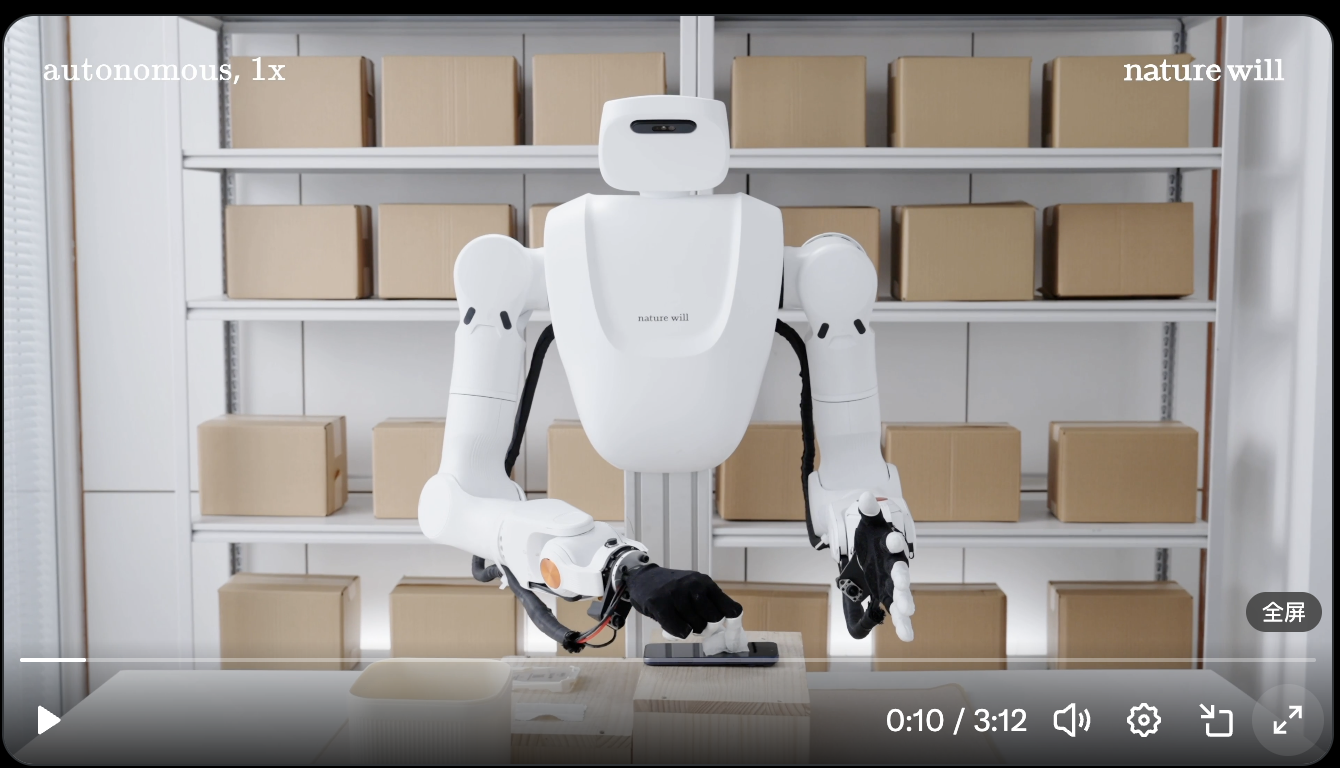
看到 Nature Well 的工作中对 Infra 有许多披露,读起来还是感到一些遗憾和心酸。我也建立过差一两个数量级的 infra,麻雀虽小但是各个节点都包括,比如 PB 级的 Lakehouse、语义标注和数据流水线等等,尤其是里边关于延迟敏感的物理模型在实时推理需要联合设计的思想。